数据回填
公测版此功能仅适用于以下阿里云地域:华东1(杭州)、华东2(上海)、华北2(北京)、华南1(深圳)、美国(弗吉尼亚)、新加坡。
数据回填能力可方便您将存放在 Zilliz Cloud Volume 中的数据填入 Zilliz Cloud Collection 中既有 Entity 的指定字段中。具体来说,数据回填任务通过主键来匹配数据文件和 Collection 中的数据。您可通过创建数据回填任务,为Collection 中的新增字段填充数据、为在指定字段上缺少数据的 Entity 补充数据,或者直接替换 Collection 中指定字段的数据。
关于为生产环境中的 Collection 添加新列并回填数据的完整流程,包括何时切换数据写入流量、何时创建 Snapshot、何时为既有 Entity 回填数据、以及如何将回填结果接入生产查询等,可以查看 Schema 演进一文中的相关介绍。
概述
下图展示了数据回填任务的主要流程。该任务由回填前检查和正式回填两个阶段构成。这两个阶段由两个独立的 API 接口实现:前者在正式回填数据前对回填数据和配置进行验证,后者则在目标 Collection 中完成数据回填任务。
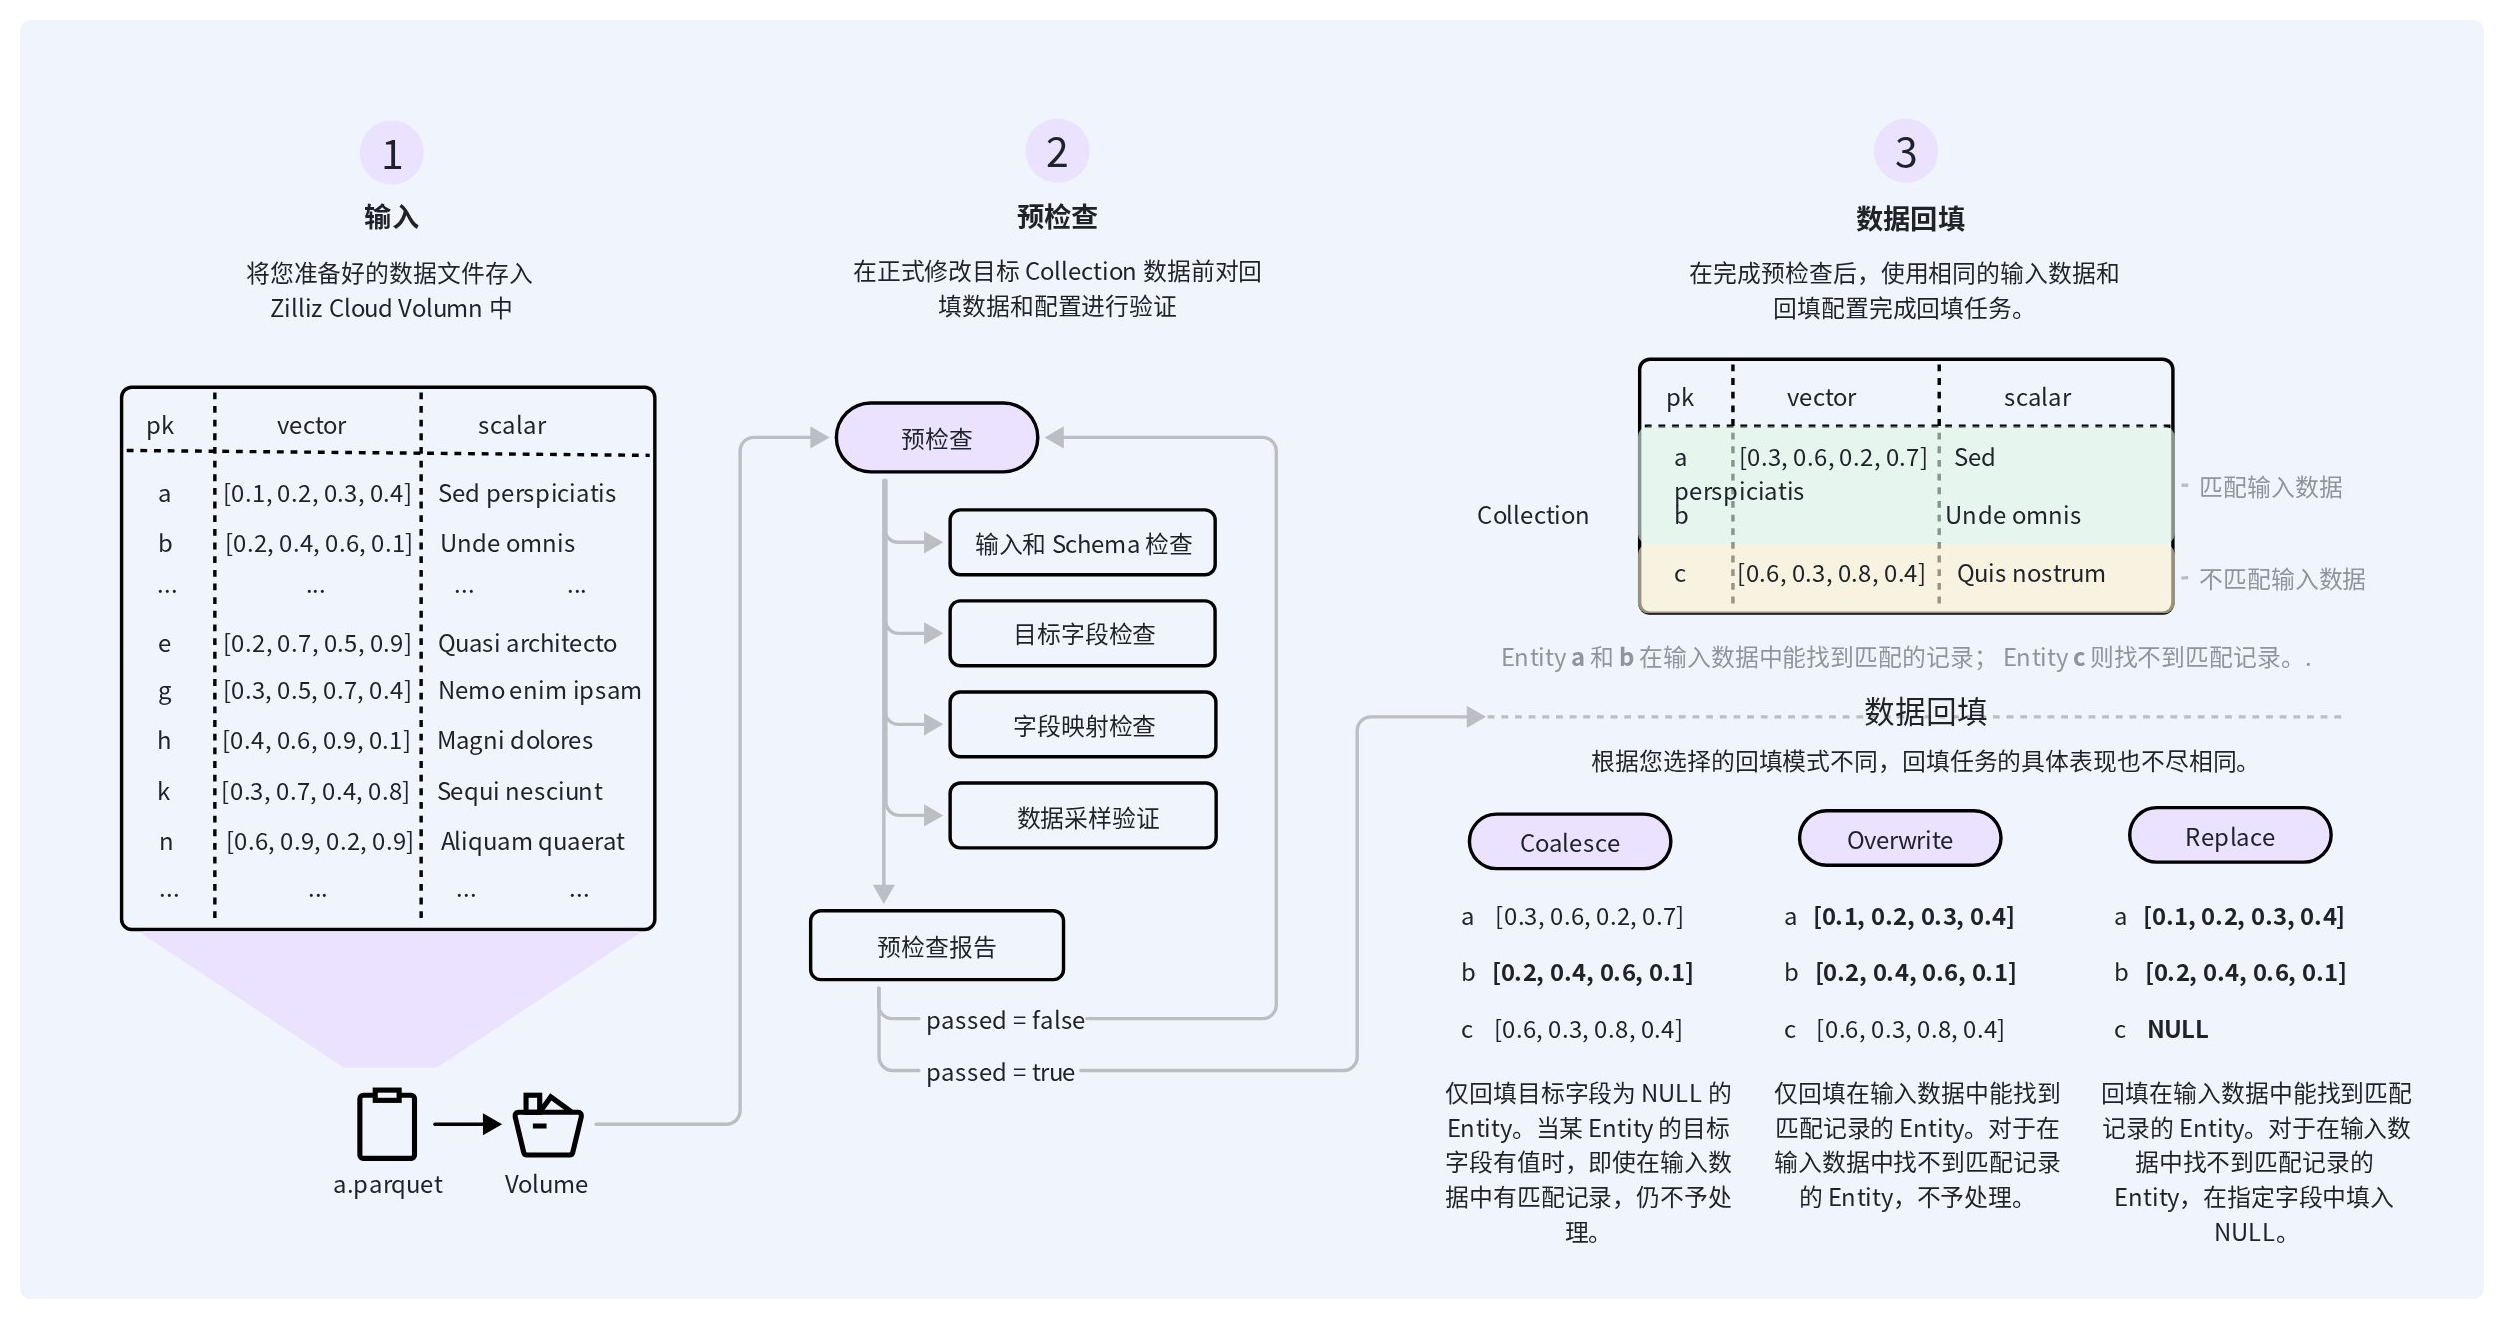
输入数据与 Collection Entity 如何匹配
输入参数中指定的数据文件里需要包含一个名为 pk 的字段。这样, Zilliz Cloud 就可以通过该字段和目标 Collection 中的 Entity 进行匹配了。需要回填的字段可以与目标 Collection 中的字段同名,也可以通过 columnMapping 显式地进行字段名称映射。需要注意的是,数据回填任务仅更新请求中指定的字段,不会也不应该在目标 Collection 中新增 Entity。
回填前检查
在执行回填之前,您可以使用相同的输入参数和字段配置进行回填前的预检查。该检查验证输入参数格式是否正确、源文件中被要求的字段是否存在、按指定的字段映射检查字段源文件和目标 Collection 中的字段是否存在,格式是否匹配、并通过对数据文件中的数据进行小规模采样检查数据是否符合要求。需要说明的是,预检查任务成功并不能说明预检查通过。您还需要检查 precheckReport.passed 这个属性的值。只有当其为 true 时,您才能进行后续操作。
选择回填模式
在创建数据回填任务时,请使用 mode 参数来控制输入数据如何应用到目标 Collection 的指定字段上。
| 回填模式 | 具体行为 |
|---|---|
coalesce | 仅回填 Collection 中与输入数据匹配,且目标字段为 NULL 的 Entity。若目标字段不为空,则以该 Entity 的原始数据为准保持不变。 |
overwrite | 仅回填 Collection 中与输入数据匹配的字段,无论其目标字段是否为 NULL。所有在输入数据中未找到匹配记录的 Entity,保持不变。 |
replace | 仅回填 Collection 中与输入数据匹配的字段,无论其目标字段是否为 NULL。对于在输入数据中未找到匹配记录的 Entity,目标字段置为 NULL。 |
当您希望只为无值的 Entity 填充数据,同时保留已有值的 Entity 的现有数据时,请使用 coalesce 模式。如果输入数据需要覆盖 Collection 中所有匹配的 Entity,可以使用 overwrite 模式。仅当输入数据完整包含 Collection 中所有 Entity 在目标记录上的取值时,才使用 replace 模式,因为该模式会清空输入数据中未找到匹配记录的 Entity 的所有目标字段。
开始前检查
在进行数据回填前检查和正式数据回填之前,请确保:
-
目标 Collection 和您希望回填的字段均已存在。
-
您的源数据已经以受支持的数据格式存入 Zilliz Cloud Volume 中。
-
输入数据的每条记录均有名为
pk的字段,用于主键匹配。 -
如果输入数据中的字段与目标 Collection 中的字段不同,请准备好字段映射(
columnMapping)。 -
目标 Collection 所在集群需要和输入数据所在 Volume 处于同一地域的同一项目中。
关于 Spark 批量任务的通用要求,包括鉴权、输入文件和输出行为,查看Spark 批量任务。
创建带预检查的数据回填任务
请在输入数据文件中包含一个用于匹配目标 Collection 主键的字段。如果目标 Collection 的任意字段名称与输入数据文件中的字段名称不同,请使用 columnMapping 参数为主键和所有目标字段建立字段映射。
准备一个幂等 Key。
幂等 Key 是一个用于判断当前请求的资源是否已经在运行的字符串。如果请求的资源已经在运行,则返回该资源。关于幂等 Key 的更多详情,可以参考幂等提交。
(可选)执行预检查。
在正式数据回填前,请可以选择执行在不修改目标 Collection 的前提下验证输入数据和配置是否符合要求。这个步骤是可选的,但仍建议您在正式回填数据前进行预检查。
如下是一个示例预检查请求体:
export precheck_payload='{
  "description": "validate backfill data",
  "clusterId": "in-xxxxxxxx",
  "dbName": "default",
  "collectionName": "products",
  "fields": ["title", "price", "embedding"],
  "input": {
    "type": "volume",
    "volumeName": "product-data",
    "path": "backfill/products.parquet",
    "format": "parquet"
  },
  "columnMapping": {
    "source_id": "id",
    "source_title": "title",
    "source_price": "price",
    "source_embedding": "embedding"
  },
  "resourceSize": "SMALL",
  "timeoutSeconds": 3600
}'
下表列出了与当前任务相关的主要参数及其描述:
| 参数名称 | 是否可选 | 参数描述 |
|---|---|---|
clusterId | 是 | Zilliz Cloud 集群 ID。 参数值为长度不超过 256 个字符的字符串。 |
dbName | 否 | 指定集群中的数据库。 参数值为长度不超过 256 个字符的字符串。 |
collectionName | 是 | 指定集群和数据库中的 Collection。 参数值为长度不超过 256 个字符的字符串。 |
fields | 是 | 指定需要回填的 Collection 中字段名称。 Zilliz Cloud 使用这些字段名称做为目录字段完成数据回填任务。参数值为字符串列表。 |
input | 是 | 回填任务的输入参数。其指向存放在 Zilliz Cloud Volume 中的数据文件。关于输入字段的详细情况,可以参考请求负载。 |
columnMapping | 否 | 输入数据文件中的各字段和目标 Collection 中各字段的映射关系。 当数据文件中的字段名称与目标 Collection 各字段名称不同时,可以使用该参数指定字段间的映射关系。一旦指定该参数,您需要将包括主键在内的所有需要回填的字段囊括进来。 |
如果您在请求中省略 columnMapping 字段,数据文件中的字段名称需要与目标 Collection 的各字段的名称一一对应。
然后,您可以参考如下方式提交预检查请求。
export API_KEY="xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx"

curl --request POST \
    --url "https://api.cloud.zilliz.com/v2/projects/{projectId}/jobs/backfill/precheck" \
    --header "Authorization: Bearer ${API_KEY}" \
    --header "Idempotency-Key: spark-job-20260730-005" \
    --header "Content-Type: application/json" \
    --data "${precheck_payload}"
该请求会立即返回一个任务 ID。您可以使用该任务 ID 获取任务的进展和检查报告。
单击此处查看预检查结果示例。
{
  "passed": false,
  "dbName": "default",
  "collectionName": "products",
  "input": "volume://product-data/backfill/products.parquet",
  "fields": ["title", "price", "embedding"],
  "columnMapping": {
    "source_id": "id",
    "source_title": "title",
    "source_price": "price",
    "source_embedding": "embedding"
  },
  "requiredSourceColumns": [
    "source_id",
    "source_title",
    "source_price",
    "source_embedding"
  ],
  "errors": [
    {
      "code": "SOURCE_COLUMN_MISSING",
      "sourceColumn": "source_embedding",
      "targetField": "embedding",
      "expectedType": "FloatVector",
      "message": "source column is missing: source_embedding"
    }
  ],
  "checkedRows": 0
}
查看预检查结果。预检查任务成功完成并不意味着输入数据通过验证。请务必检查报告中的 passed 字段。当其为 false 时,请检查报告中的 errors 字段获取错误详情,并对输入数据和配置进行相应的修改。
下表列出了可用的数据验证错误码。
| 错误码 | 错误码描述 |
|---|---|
SOURCE_COLUMN_MISSING | 表示数据文件中不包含请求中指定的字段。 |
SOURCE_COLUMN_TYPE_MISMATCH | 表示数据文件中指定字段的数据类型与目标 Collection 中相应字段的数据类型不一致。 |
提交数据回填任务。
数据回填请求的大部分字段与预检查请求一致,除了 mode 参数。您可以通过设置 mode 参数来控制输入数据以何种方式应用于目标 Collection。 coalesce 为默认模式。关于支持的回填模式及其含义,可以参考选择回填模式。
export backfill_payload='{
  "description": "backfill product data",
  "clusterId": "in-xxxxxxxx",
  "dbName": "default",
  "collectionName": "products",
  "fields": ["title", "price", "embedding"],
  "input": {
    "type": "volume",
    "volumeName": "product-data",
    "path": "backfill/products.parquet",
    "format": "parquet"
  },
  "columnMapping": {
    "source_id": "id",
    "source_title": "title",
    "source_price": "price",
    "source_embedding": "embedding"
  },
  "mode": "coalesce",
  "resourceSize": "SMALL",
  "timeoutSeconds": 3600
}'
在您选择了合适的回填模式后,可以参考如下示例提交数据回填请求。
export API_KEY="xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx"

curl --request POST \
    --url "https://api.cloud.zilliz.com/v2/projects/{projectId}/jobs/backfill" \
    --header "Authorization: Bearer ${API_KEY}" \
    --header "Idempotency-Key: spark-job-20260730-006" \
    --header "Content-Type: application/json" \
    --data "${backfill_payload}"
单击此处查看数据回填结果示例。
{
  "code": 0,
  "data": {
    "jobId": "job-xxxxxxxx",
    "projectId": "proj-xxxxxxxx",
    "type": "SPARK",
    "description": "backfill product attributes",
    "status": "FAILED",
    "regionId": "aws-us-west-2",
    "clusterId": "in-xxxxxxxx",
    "artifact": null,
    "details": {
      "dbName": "default",
      "collectionName": "products",
      "input": {
        "type": "volume",
        "volumeName": "product-data",
        "path": "backfill/products.parquet",
        "format": "parquet"
      },
      "fields": ["title", "price", "embedding"],
      "columnMapping": {
        "source_id": "id",
        "source_title": "title",
        "source_price": "price",
        "source_embedding": "embedding"
      },
      "mode": "coalesce",
      "resourceSize": "SMALL"
    },
    "precheckReport": null,
    "failureReason": {
      "code": "SPARK_EXECUTION_FAILED",
      "message": "The Spark job failed.",
      "retryable": false
    },
    "createdAt": "2026-08-21T02:00:00Z",
    "submittedAt": "2026-08-21T02:00:30Z",
    "startedAt": "2026-08-21T02:01:00Z",
    "finishedAt": "2026-08-21T02:10:00Z",
    "durationSeconds": 540
  }
}
该请求会立即返回一个任务 ID。您可以使用该任务 ID 获取任务的进展和数据回填结果,包括目标 Collection、输入数据、字段映射及为当前任务分配的资源情况。
监控任务
在提交请求后,使用返回的任务 ID 监控任务直到其抵达某个终结状态。您可以查看任务的当前状态及详细信息,列出当前已经创建的任务,或在任务尚可取消时取消某个任务。
当任务成功后,验证请求中指定的输出路径下是否按预期出现了输出文件。
关于相关监控任务的请求、任务状态及状态流转的详细情况,可以参考管理 Spark 批量任务。
验证结果
在数据回填任务成功结束后,您可以检查目标字段中的数据是否符合预期。也可以用有代表性的采样数据尝试进行数据查询操作,并将回填数据与输入数据文件中的数据进行比对。
您还可以验证数据是否按照指定的回填模式完成回填。对于 coalesce 模式,所有目标字段不为 NULL 的匹配 Entity 都会在目标字段上保持回填前的值。对于 overwrite 模式,所有在输入数据中找不到匹配记录的 Entity,其目标字段值与回填前相同。对于 replace 模式,所有在输入数据中找不到匹配记录的 Entity,其目标字段的值均为 NULL。
对于大规模数据回填任务,您还可以检查更新数据的覆盖率来识别可能存在的漏值或回填值不符合预期等情况。
下一步
在完成回填数据检查后,您就可以在您的应用或工作流程中使用这批已更新的数据。
例如,您可以将数据回填当成 Schema 变更任务的一个环节。关于 Schema 变更的完整迁移流程,可以参考 Schema 变更。