Language Identifier
语言识别器(language_identifier)是一种专用分词器,用于增强 Zilliz Cloud 的文本搜索能力,它通过自动化语言分析流程来实现。其主要功能是检测文本字段的语言,然后动态应用最适合该语言的预配置分析器。这对处理多语言的应用尤为重要,因为它免去了逐条输入手动指定语言的麻烦。
通过智能地将文本数据路由到合适的处理管道,language_identifier 简化了多语言数据的导入流程,并确保后续搜索与检索操作中的分词准确性。
工作流程
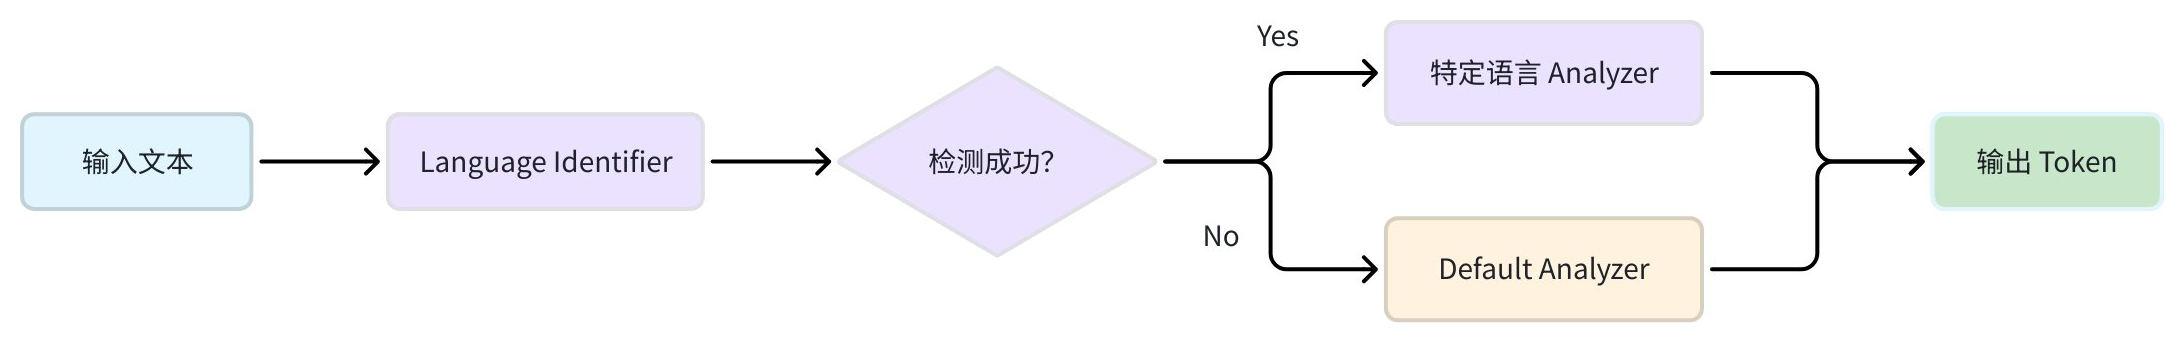
language_identifier 在处理文本字符串时会执行一系列步骤,用户理解这些步骤对于正确配置它至关重要。
-
输入:工作流程以一个文本字符串作为输入。
-
语言检测:该字符串首先被传递到语言检测引擎,系统尝试识别其语言。Zilliz Cloud 支持两个引擎:whatlang 和 lingua。
-
Analyzer 选择:
-
成功情况:如果成功识别出语言,系统会检查该语言名称是否在
analyzers字典中配置了对应的 Analyzer。如果找到匹配项,系统将对输入文本应用该分析器。例如,检测到 “Mandarin” 时,文本会路由到jieba分词器。 -
回退情况:如果检测失败,或成功检测到语言但未配置对应分析器,系统会使用预先配置的
defaultAnalyzer。这点非常关键:defaultAnalyzer 既是检测失败的兜底方案,也是未匹配到 Analyzer 时的兜底方案。
-
在选择到合适的分析器后,文本会被分词并处理,从而完成整个工作流程。
可用的语言检测引擎
Zilliz Cloud 提供两种语言检测引擎可选:
选择取决于应用对性能与精度的需求。
| 引擎 | 速度 | 精度 | 输出格式 | 适用场景 |
|---|---|---|---|---|
whatlang | 快速 | 大多数语言精度良好 | 语言名称(如 "English", "Mandarin", "Japanese")参考:支持语言表中的 Language 列 | 对实时性要求高的应用 |
lingua | 较慢 | 精度更高,尤其适用于短文本 | 英文语言名(如 "English", "Chinese", "Japanese")参考:支持语言列表 | 精度优先的应用场景 |
注意:两种引擎虽然都返回英文语言名,但部分语言的命名不同(例如,whatlang 返回 Mandarin,而 lingua 返回 Chinese)。分析器的 key 必须与所选检测引擎返回的语言名完全一致。
配置
要正确使用 language_identifier 分词器,需要完成以下配置步骤。
步骤 1:选择语言与分析器
设置 language_identifier 的核心是为计划支持的语言配置合适的分析器。系统会将检测到的语言与分析器对应匹配,因此这是保证文本处理准确性的关键。
下面是推荐的语言与 Zilliz Cloud 分析器映射表。该表帮助你将语言检测引擎的输出与最合适的工具建立对应关系。
| 语言(检测引擎输出) | 推荐分析器 | 描述 |
|---|---|---|
English | type: english | 标准英文分词,带词干提取与停用词过滤 |
Mandarin(whatlang 输出)或 Chinese(lingua 输出) | tokenizer: jieba | 中文分词,适用于无空格分隔的文本 |
Japanese | tokenizer: icu | 强大的分词器,适用于复杂文字体系,包括日语 |
French | type: standard, filter: ["lowercase", "asciifolding"] | 自定义配置,用于处理法语重音符与特殊字符 |
-
匹配是关键:分析器名称必须与检测引擎返回的语言名完全一致。例如,若使用 whatlang,则中文文本的 key 必须是 Mandarin。
-
最佳实践:上表仅列出部分常见语言的推荐配置,更多情况请参考最佳实践。
-
检测器输出:完整语言名称列表请参考:
步骤 2:定义 analyzer_params
在 Zilliz Cloud 中使用 language_identifier 分词器时,需要创建一个包含以下关键组件的字典:
必需组件:
-
analyzers配置集 – 包含所有分析器配置的字典,必须包括:-
default– 兜底分析器,用于检测失败或无匹配分析器时 -
特定语言分析器 – 定义为
<analyzer_name>: <analyzer_config>,其中:-
analyzer_name必须与所选检测引擎的输出完全一致(如 "English", "Japanese") -
analyzer_config遵循标准分析器参数格式(见《分析器概览》)
-
-
可选组件:
-
identifier– 指定使用的语言检测引擎(whatlang 或 lingua),若未指定则默认为 whatlang -
mapping– 为分析器创建自定义别名,可以用更具描述性的名称替代检测引擎的原始输出
运行逻辑:分词器会先检测输入文本的语言,再从配置中选择合适的分析器。如果检测失败或没有匹配分析器,会自动回退到默认分析器。
推荐:直接名称匹配
最佳做法是让你的分析器名称与所选语言检测引擎的输出保持完全一致。这种方式更简单,也能避免混淆。
无论使用 whatlang 还是 lingua,请严格按照官方文档中的语言名:
-
whatlang 支持语言表(使用 Language 列)
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
analyzer_params = {
    "tokenizer": {
        "type": "language_identifier",  # Must be `language_identifier`
        "identifier": "whatlang",  # or `lingua`
        "analyzers": {  # A set of analyzer configs
            "default": {
                "tokenizer": "standard"  # fallback if language detection fails
            },
            "English": {  # Analyzer name that matches whatlang output
                "type": "english"
            },
            "Mandarin": {  # Analyzer name that matches whatlang output
                "tokenizer": "jieba"
            }
        }
    }
}
import java.util.HashMap;
import java.util.Map;

Map<String, Object> analyzerParams = new HashMap<>();

Map<String, Object> defaultAnalyzer = new HashMap<>();
defaultAnalyzer.put("tokenizer", "standard");

Map<String, Object> englishAnalyzer = new HashMap<>();
englishAnalyzer.put("type", "english");

Map<String, Object> mandarinAnalyzer = new HashMap<>();
mandarinAnalyzer.put("tokenizer", "jieba");

Map<String, Object> analyzers = new HashMap<>();
analyzers.put("default", defaultAnalyzer);
analyzers.put("English", englishAnalyzer);
analyzers.put("Mandarin", mandarinAnalyzer);

Map<String, Object> tokenizer = new HashMap<>();
tokenizer.put("type", "language_identifier");
tokenizer.put("identifier", "whatlang");
tokenizer.put("analyzers", analyzers);

analyzerParams.put("tokenizer", tokenizer);
analyzerParams := map[string]any{
    "tokenizer": map[string]any{
        "type":       "language_identifier",
        "identifier": "whatlang",
        "analyzers": map[string]any{
            "default":  map[string]any{"tokenizer": "standard"},
            "English":  map[string]any{"type": "english"},
            "Mandarin": map[string]any{"tokenizer": "jieba"},
        },
    },
}
let analyzer_params = serde_json::json!({
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "whatlang",
        "analyzers": {
            "default": {"tokenizer": "standard"},
            "English": {"type": "english"},
            "Mandarin": {"tokenizer": "jieba"}
        }
    }
});
nlohmann::json analyzer_params = {
    {"tokenizer", {
        {"type", "language_identifier"},
        {"identifier", "whatlang"},
        {"analyzers", {
            {"default", {{"tokenizer", "standard"}}},
            {"English", {{"type", "english"}}},
            {"Mandarin", {{"tokenizer", "jieba"}}}
        }}
    }}
};
const analyzer_params = {
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "whatlang",
        "analyzers": {
            "default": {"tokenizer": "standard"},
            "English": {"type": "english"},
            "Mandarin": {"tokenizer": "jieba"}
        }
    }
};
# restful
analyzerParams='{
  "tokenizer": {
    "type": "language_identifier",
    "identifier": "whatlang",
    "analyzers": {
      "default": {
        "tokenizer": "standard"
      },
      "English": {
        "type": "english"
      },
      "Mandarin": {
        "tokenizer": "jieba"
      }
    }
  }
}'
替代方法:使用映射的自定义名称
如果你更倾向于使用自定义的分析器名称,或需要与现有配置保持兼容,可以使用 mapping 参数。这样就能为分析器创建别名——既可以使用检测引擎返回的原始名称,也可以使用你自定义的名称。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
analyzer_params = {
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "lingua",
        "analyzers": {
            "default": {
                "tokenizer": "standard"
            },
            "english_analyzer": {  # Custom analyzer name
                "type": "english"
            },
            "chinese_analyzer": {  # Custom analyzer name
                "tokenizer": "jieba"
            }
        },
        "mapping": {
            "English": "english_analyzer",   # Maps detection output to custom name
            "Chinese": "chinese_analyzer"
        }
    }
}
import java.util.HashMap;
import java.util.Map;

Map<String, Object> analyzerParams = new HashMap<>();

Map<String, Object> defaultAnalyzer = new HashMap<>();
defaultAnalyzer.put("tokenizer", "standard");

Map<String, Object> englishAnalyzer = new HashMap<>();
englishAnalyzer.put("type", "english");

Map<String, Object> chineseAnalyzer = new HashMap<>();
chineseAnalyzer.put("tokenizer", "jieba");

Map<String, Object> analyzers = new HashMap<>();
analyzers.put("default", defaultAnalyzer);
analyzers.put("english_analyzer", englishAnalyzer);
analyzers.put("chinese_analyzer", chineseAnalyzer);

Map<String, Object> mapping = new HashMap<>();
mapping.put("English", "english_analyzer");
mapping.put("Chinese", "chinese_analyzer");

Map<String, Object> tokenizer = new HashMap<>();
tokenizer.put("type", "language_identifier");
tokenizer.put("identifier", "lingua");
tokenizer.put("analyzers", analyzers);
tokenizer.put("mapping", mapping);

analyzerParams.put("tokenizer", tokenizer);
analyzerParams := map[string]any{
    "tokenizer": map[string]any{
        "type":       "language_identifier",
        "identifier": "lingua",
        "analyzers": map[string]any{
            "default":           map[string]any{"tokenizer": "standard"},
            "english_analyzer":  map[string]any{"type": "english"},
            "chinese_analyzer":  map[string]any{"tokenizer": "jieba"},
        },
        "mapping": map[string]any{
            "English": "english_analyzer",
            "Chinese": "chinese_analyzer",
        },
    },
}
let analyzer_params = serde_json::json!({
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "lingua",
        "analyzers": {
            "default": {"tokenizer": "standard"},
            "english_analyzer": {"type": "english"},
            "chinese_analyzer": {"tokenizer": "jieba"}
        },
        "mapping": {
            "English": "english_analyzer",
            "Chinese": "chinese_analyzer"
        }
    }
});
nlohmann::json analyzer_params = {
    {"tokenizer", {
        {"type", "language_identifier"},
        {"identifier", "lingua"},
        {"analyzers", {
            {"default", {{"tokenizer", "standard"}}},
            {"english_analyzer", {{"type", "english"}}},
            {"chinese_analyzer", {{"tokenizer", "jieba"}}}
        }},
        {"mapping", {
            {"English", "english_analyzer"},
            {"Chinese", "chinese_analyzer"}
        }}
    }}
};
const analyzer_params = {
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "lingua",
        "analyzers": {
            "default": {"tokenizer": "standard"},
            "english_analyzer": {"type": "english"},
            "chinese_analyzer": {"tokenizer": "jieba"}
        },
        "mapping": {
            "English": "english_analyzer",
            "Chinese": "chinese_analyzer"
        }
    }
};
# restful
analyzerParams='{
  "tokenizer": {
    "type": "language_identifier",
    "identifier": "lingua",
    "analyzers": {
      "default": {
        "tokenizer": "standard"
      },
      "english_analyzer": {
        "type": "english"
      },
      "chinese_analyzer": {
        "tokenizer": "jieba"
      }
    },
    "mapping": {
      "English": "english_analyzer",
      "Chinese": "chinese_analyzer"
    }
  }
}'
定义 analyzer_params 后,您可以在定义 Collection Schema 时将其应用于 VARCHAR 字段。这使得 Zilliz Cloud 能够使用指定的分析器处理该字段中的文本,以实现高效的分词和过滤。更多信息,请参阅使用示例。
示例
以下是一些常见场景的即用型配置示例。每个示例都包含配置和验证代码,方便你立即测试设置。
中英文检测
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
from pymilvus import MilvusClient

# Configuration
analyzer_params = {
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "whatlang",
        "analyzers": {
            "default": {"tokenizer": "standard"},
            "English": {"type": "english"},
            "Mandarin": {"tokenizer": "jieba"}
        }
    }
}

# Test the configuration
client = MilvusClient(
    uri="YOUR_CLUSTER_ENDPOINT",
    token="YOUR_CLUSTER_TOKEN"
)

# English text
result_en = client.run_analyzer("The Milvus vector database is built for scale!", analyzer_params)
print("English:", result_en)
# Output:
# English: ['The', 'Milvus', 'vector', 'database', 'is', 'built', 'for', 'scale']

# Chinese text
result_cn = client.run_analyzer("Milvus向量数据库专为大规模应用而设计", analyzer_params)
print("Chinese:", result_cn)
# Output:
# Chinese: ['Milvus', '向量', '数据', '据库', '数据库', '专', '为', '大规', '规模', '大规模', '应用', '而', '设计']
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.vector.request.RunAnalyzerReq;
import io.milvus.v2.service.vector.response.RunAnalyzerResp;

import java.util.ArrayList;
import java.util.Collections;
import java.util.HashMap;
import java.util.List;
import java.util.Map;

// Configuration
Map<String, Object> analyzerParams = new HashMap<>();
Map<String, Object> analyzers = new HashMap<>();
analyzers.put("default", Collections.singletonMap("tokenizer", "standard"));
analyzers.put("English", Collections.singletonMap("type", "english"));
analyzers.put("Mandarin", Collections.singletonMap("tokenizer", "jieba"));
Map<String, Object> tokenizer = new HashMap<>();
tokenizer.put("type", "language_identifier");
tokenizer.put("identifier", "whatlang");
tokenizer.put("analyzers", analyzers);
analyzerParams.put("tokenizer", tokenizer);

// Test the configuration
ConnectConfig config = ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN")
        .build();
MilvusClientV2 client = new MilvusClientV2(config);

// English text
RunAnalyzerResp resultEn = client.runAnalyzer(RunAnalyzerReq.builder()
        .texts(Collections.singletonList("The Milvus vector database is built for scale!"))
        .analyzerParams(analyzerParams)
        .build());
System.out.println("English: " + resultEn.getResults());

// Chinese text
RunAnalyzerResp resultCn = client.runAnalyzer(RunAnalyzerReq.builder()
        .texts(Collections.singletonList("Milvus向量数据库专为大规模应用而设计"))
        .analyzerParams(analyzerParams)
        .build());
System.out.println("Chinese: " + resultCn.getResults());
import (
    "context"
    "encoding/json"
    "fmt"

    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

// Configuration
analyzerParams := map[string]any{
    "tokenizer": map[string]any{
        "type":       "language_identifier",
        "identifier": "whatlang",
        "analyzers": map[string]any{
            "default":  map[string]any{"tokenizer": "standard"},
            "English":  map[string]any{"type": "english"},
            "Mandarin": map[string]any{"tokenizer": "jieba"},
        },
    },
}

// Test the configuration
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: "YOUR_CLUSTER_ENDPOINT",
    APIKey:  "YOUR_CLUSTER_TOKEN",
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

bs, _ := json.Marshal(analyzerParams)

// English text
resultEn, err := client.RunAnalyzer(ctx, milvusclient.NewRunAnalyzerOption(
    "The Milvus vector database is built for scale!").WithAnalyzerParamsStr(string(bs)))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
fmt.Println("English:", resultEn)

// Chinese text
resultCn, err := client.RunAnalyzer(ctx, milvusclient.NewRunAnalyzerOption(
    "Milvus向量数据库专为大规模应用而设计").WithAnalyzerParamsStr(string(bs)))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
fmt.Println("Chinese:", resultCn)
use milvus::v2::error::Result;
use milvus::v2::prelude::*;
use serde_json::json;

#[tokio::main]
async fn main() -> Result<()> {
    let config = ConnectConfig::new().uri("YOUR_CLUSTER_ENDPOINT").token("YOUR_CLUSTER_TOKEN");
    let client = ClientV2::new(&config).await?;

    // Configuration
    let analyzer_params = json!({
        "tokenizer": {
            "type": "language_identifier",
            "identifier": "whatlang",
            "analyzers": {
                "default": {"tokenizer": "standard"},
                "English": {"type": "english"},
                "Mandarin": {"tokenizer": "jieba"}
            }
        }
    });

    // English text
    let result_en = client.run_analyzer(
        RunAnalyzerRequest::builder()
            .texts(["The Milvus vector database is built for scale!".to_string()])
            .analyzer_params(analyzer_params.clone())
            .build()?,
    ).await?;
    println!("English: {:?}", result_en.results());

    // Chinese text
    let result_cn = client.run_analyzer(
        RunAnalyzerRequest::builder()
            .texts(["Milvus向量数据库专为大规模应用而设计".to_string()])
            .analyzer_params(analyzer_params)
            .build()?,
    ).await?;
    println!("Chinese: {:?}", result_cn.results());
    Ok(())
}
#include "milvus/MilvusClientV2.h"

#include <iostream>
#include <string>

// Configuration
nlohmann::json analyzer_params = {
    {"tokenizer", {
        {"type", "language_identifier"},
        {"identifier", "whatlang"},
        {"analyzers", {
            {"default", {{"tokenizer", "standard"}}},
            {"English", {{"type", "english"}}},
            {"Mandarin", {{"tokenizer", "jieba"}}}
        }}
    }}
};

// Test the configuration
auto client = milvus::MilvusClientV2::Create();
milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT", "YOUR_CLUSTER_TOKEN"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

// English text
milvus::RunAnalyzerResponse response;
status = client->RunAnalyzer(milvus::RunAnalyzerRequest()
                                .AddText("The Milvus vector database is built for scale!")
                                .WithAnalyzerParams(analyzer_params),
                             response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
for (const auto& result : response.Results()) {
    for (const auto& token : result.Tokens()) {
        std::cout << token.token_ << " ";
    }
    std::cout << std::endl;
}

// Chinese text
status = client->RunAnalyzer(milvus::RunAnalyzerRequest()
                                .AddText("Milvus向量数据库专为大规模应用而设计")
                                .WithAnalyzerParams(analyzer_params),
                             response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
for (const auto& result : response.Results()) {
    for (const auto& token : result.Tokens()) {
        std::cout << token.token_ << " ";
    }
    std::cout << std::endl;
}
// javascript
import { MilvusClient } from '@zilliz/milvus2-sdk-node';

// Configuration
const analyzer_params = {
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "whatlang",
        "analyzers": {
            "default": {"tokenizer": "standard"},
            "English": {"type": "english"},
            "Mandarin": {"tokenizer": "jieba"}
        }
    }
};

// Test the configuration
const client = new MilvusClient({
  address: 'YOUR_CLUSTER_ENDPOINT',
  token: 'YOUR_CLUSTER_TOKEN'
});

// English text
const resultEn = await client.runAnalyzer({
  text: 'The Milvus vector database is built for scale!',
  analyzer_params: analyzer_params
});
console.log('English:', resultEn);

// Chinese text
const resultCn = await client.runAnalyzer({
  text: 'Milvus向量数据库专为大规模应用而设计',
  analyzer_params: analyzer_params
});
console.log('Chinese:', resultCn);
# restful
curl --request POST \
  --url "${CLUSTER_ENDPOINT}/v2/vectordb/common/run_analyzer" \
  --header "Authorization: Bearer ${TOKEN}" \
  --header "Content-Type: application/json" \
  --data '{
    "analyzerParams": "{\"tokenizer\":{\"type\":\"language_identifier\",\"identifier\":\"whatlang\",\"analyzers\":{\"default\":{\"tokenizer\":\"standard\"},\"English\":{\"type\":\"english\"},\"Mandarin\":{\"tokenizer\":\"jieba\"}}}}",
    "text": ["The Milvus vector database is built for scale!"]
  }'

curl --request POST \
  --url "${CLUSTER_ENDPOINT}/v2/vectordb/common/run_analyzer" \
  --header "Authorization: Bearer ${TOKEN}" \
  --header "Content-Type: application/json" \
  --data '{
    "analyzerParams": "{\"tokenizer\":{\"type\":\"language_identifier\",\"identifier\":\"whatlang\",\"analyzers\":{\"default\":{\"tokenizer\":\"standard\"},\"English\":{\"type\":\"english\"},\"Mandarin\":{\"tokenizer\":\"jieba\"}}}}",
    "text": ["Milvus向量数据库专为大规模应用而设计"]
  }'
欧洲语言检测
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
# Configuration for French, German, Spanish, etc.
analyzer_params = {
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "lingua",
        "analyzers": {
            "default": {"tokenizer": "standard"},
            "English": {"type": "english"},
            "French": {
                "tokenizer": "standard",
                "filter": ["lowercase", "asciifolding"]
            }
        }
    }
}

# Test with accented text
client = MilvusClient(
    uri="YOUR_CLUSTER_ENDPOINT",
    token="YOUR_CLUSTER_TOKEN"
)

result_fr = client.run_analyzer("Café français très délicieux", analyzer_params)
print("French:", result_fr)
# Output:
# French: ['cafe', 'francais', 'tres', 'delicieux']
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.service.vector.request.RunAnalyzerReq;
import io.milvus.v2.service.vector.response.RunAnalyzerResp;

import java.util.Arrays;
import java.util.Collections;
import java.util.HashMap;
import java.util.Map;

// Configuration for French, German, Spanish, etc.
Map<String, Object> analyzerParams = new HashMap<>();
Map<String, Object> frenchAnalyzer = new HashMap<>();
frenchAnalyzer.put("tokenizer", "standard");
frenchAnalyzer.put("filter", Arrays.asList("lowercase", "asciifolding"));
Map<String, Object> analyzers = new HashMap<>();
analyzers.put("default", Collections.singletonMap("tokenizer", "standard"));
analyzers.put("English", Collections.singletonMap("type", "english"));
analyzers.put("French", frenchAnalyzer);
Map<String, Object> tokenizer = new HashMap<>();
tokenizer.put("type", "language_identifier");
tokenizer.put("identifier", "lingua");
tokenizer.put("analyzers", analyzers);
analyzerParams.put("tokenizer", tokenizer);

// Test with accented text
ConnectConfig config = ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN")
        .build();
MilvusClientV2 client = new MilvusClientV2(config);

RunAnalyzerResp resultFr = client.runAnalyzer(RunAnalyzerReq.builder()
        .texts(Collections.singletonList("Café français très délicieux"))
        .analyzerParams(analyzerParams)
        .build());
System.out.println("French: " + resultFr.getResults());
import (
    "context"
    "encoding/json"
    "fmt"

    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

// Configuration for French, German, Spanish, etc.
analyzerParams := map[string]any{
    "tokenizer": map[string]any{
        "type":       "language_identifier",
        "identifier": "lingua",
        "analyzers": map[string]any{
            "default": map[string]any{"tokenizer": "standard"},
            "English": map[string]any{"type": "english"},
            "French": map[string]any{
                "tokenizer": "standard",
                "filter":    []any{"lowercase", "asciifolding"},
            },
        },
    },
}

// Test with accented text
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: "YOUR_CLUSTER_ENDPOINT",
    APIKey:  "YOUR_CLUSTER_TOKEN",
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}

bs, _ := json.Marshal(analyzerParams)

resultFr, err := client.RunAnalyzer(ctx, milvusclient.NewRunAnalyzerOption(
    "Café français très délicieux").WithAnalyzerParamsStr(string(bs)))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
fmt.Println("French:", resultFr)
use milvus::v2::error::Result;
use milvus::v2::prelude::*;
use serde_json::json;

#[tokio::main]
async fn main() -> Result<()> {
    let config = ConnectConfig::new().uri("YOUR_CLUSTER_ENDPOINT").token("YOUR_CLUSTER_TOKEN");
    let client = ClientV2::new(&config).await?;

    // Configuration for French, German, Spanish, etc.
    let analyzer_params = json!({
        "tokenizer": {
            "type": "language_identifier",
            "identifier": "lingua",
            "analyzers": {
                "default": {"tokenizer": "standard"},
                "English": {"type": "english"},
                "French": {
                    "tokenizer": "standard",
                    "filter": ["lowercase", "asciifolding"]
                }
            }
        }
    });

    // Test with accented text
    let result_fr = client.run_analyzer(
        RunAnalyzerRequest::builder()
            .texts(["Café français très délicieux".to_string()])
            .analyzer_params(analyzer_params)
            .build()?,
    ).await?;
    println!("French: {:?}", result_fr.results());
    Ok(())
}
#include "milvus/MilvusClientV2.h"

#include <iostream>
#include <string>

// Configuration for French, German, Spanish, etc.
nlohmann::json analyzer_params = {
    {"tokenizer", {
        {"type", "language_identifier"},
        {"identifier", "lingua"},
        {"analyzers", {
            {"default", {{"tokenizer", "standard"}}},
            {"English", {{"type", "english"}}},
            {"French", {
                {"tokenizer", "standard"},
                {"filter", {"lowercase", "asciifolding"}}
            }}
        }}
    }}
};

// Test with accented text
auto client = milvus::MilvusClientV2::Create();
milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT", "YOUR_CLUSTER_TOKEN"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

milvus::RunAnalyzerResponse response;
status = client->RunAnalyzer(milvus::RunAnalyzerRequest()
                                .AddText("Café français très délicieux")
                                .WithAnalyzerParams(analyzer_params),
                             response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
for (const auto& result : response.Results()) {
    for (const auto& token : result.Tokens()) {
        std::cout << token.token_ << " ";
    }
    std::cout << std::endl;
}
// javascript
import { MilvusClient } from '@zilliz/milvus2-sdk-node';

// Configuration for French, German, Spanish, etc.
const analyzer_params = {
    "tokenizer": {
        "type": "language_identifier",
        "identifier": "lingua",
        "analyzers": {
            "default": {"tokenizer": "standard"},
            "English": {"type": "english"},
            "French": {
                "tokenizer": "standard",
                "filter": ["lowercase", "asciifolding"]
            }
        }
    }
};

// Test with accented text
const client = new MilvusClient({
  address: 'YOUR_CLUSTER_ENDPOINT',
  token: 'YOUR_CLUSTER_TOKEN'
});

const resultFr = await client.runAnalyzer({
  text: 'Café français très délicieux',
  analyzer_params: analyzer_params
});
console.log('French:', resultFr);
# restful
curl --request POST \
  --url "${CLUSTER_ENDPOINT}/v2/vectordb/common/run_analyzer" \
  --header "Authorization: Bearer ${TOKEN}" \
  --header "Content-Type: application/json" \
  --data '{
    "analyzerParams": "{\"tokenizer\":{\"type\":\"language_identifier\",\"identifier\":\"lingua\",\"analyzers\":{\"default\":{\"tokenizer\":\"standard\"},\"English\":{\"type\":\"english\"},\"French\":{\"tokenizer\":\"standard\",\"filter\":[\"lowercase\",\"asciifolding\"]}}}}",
    "text": ["Café français très délicieux"]
  }'
使用须知
-
每字段单一语言:该功能以字段为单位,将其视为单一、同质化的文本块。它旨在处理不同数据记录中的不同语言,例如一条记录是英文句子,下一条记录是法文句子。
-
不支持混合语言字符串:它不适用于单个字符串中包含多种语言的情况。例如,一个 VARCHAR 字段同时包含英文句子和日文引语时,系统会将其作为单一语言来处理。
-
主导语言处理:在多语言混合场景下,检测引擎通常会识别主导语言,并对整个文本应用对应的分析器。这会导致嵌入的外语部分分词效果不佳,甚至无法分词。