MinHash Function
公测版MinHash Function 可将原始文本转换为二进制向量,用于近似表示文档之间的 Jaccard 相似度。该 Function 会对文本进行 Shingling,并应用多个哈希函数生成固定长度的签名向量,从而支持大规模近重复检测和文档去重。
MinHash 是 Zilliz Cloud 内置 Function,不需要外部模型推理或预处理。您只需插入原始文本,Zilliz Cloud 会自动生成 MinHash 签名向量。
限制
输出字段必须是 BINARY_VECTOR,且维度必须满足 dim % 32 == 0,因为每个 MinHash 签名值都是 32-bit 哈希值。
二进制向量字段的维度必须等于 32 * num_hashes。维度不匹配会导致报错。
使用 MINHASH_LSH 索引处理 MinHash Function 输出时,mh_element_bit_width 必须设置为 32。
MinHash 工作原理
展开了解 MinHash 工作原理
MinHash 是一种局部敏感哈希(Locality-Sensitive Hashing,LSH)技术,用于估算集合之间的 Jaccard 相似度。在 Zilliz Cloud 中,MinHash Function 遵循以下流程:您提供原始文本作为输入,Zilliz Cloud 生成二进制向量作为输出,并在内部完成所有中间处理步骤。
整体流程由两部分组成:文档写入和查询处理共用的文本处理流水线,以及写入和检索阶段各自的后续操作。
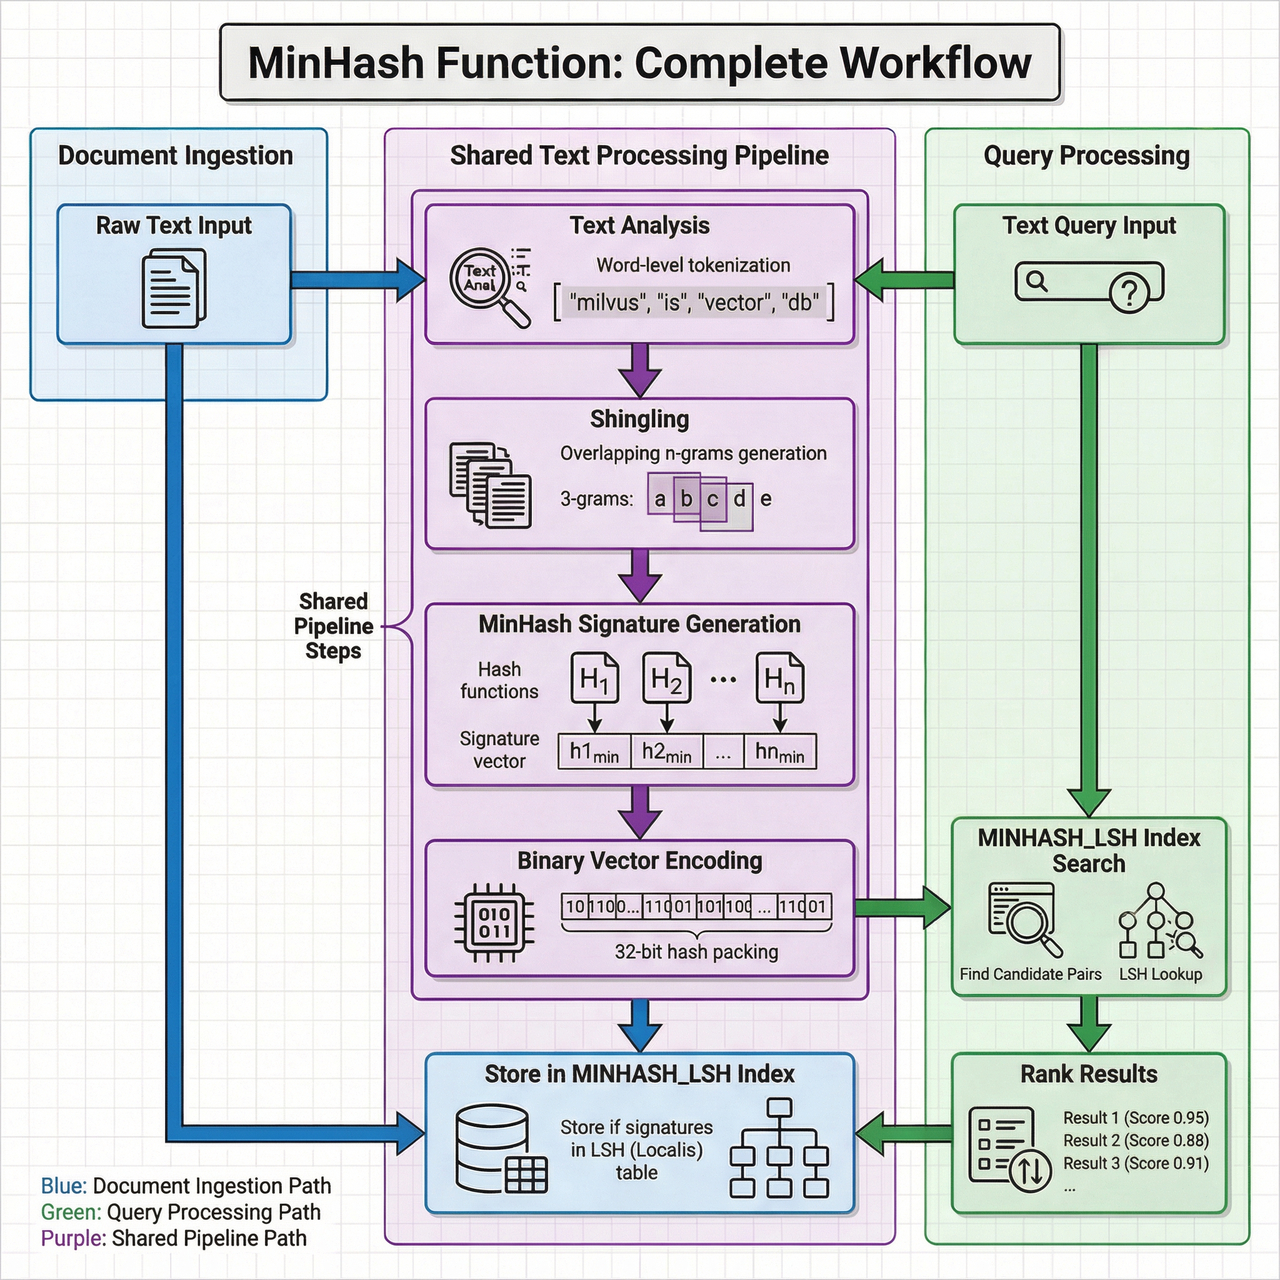
共享文本处理流水线
文档写入和查询处理都会将原始文本传入同一套四阶段转换流程:
-
文本分析:当
token_level为"word"时,文本会由 Analyzer 概述处理;当token_level为"char"时,文本会直接使用原始字符。词级别分词会使用输入字段上配置的 Analyzer 将文本切分为词元。例如,"milvus is vector db"会被切分为["milvus", "is", "vector", "db"]。 -
Shingling:词元会被切分为大小为
shingle_size的重叠 n-gram(Shingle)。例如,在词级别使用 3-gram 时,词元["information", "retrieval", "is", "a", "field"]会生成["information retrieval is", "retrieval is a", "is a field"]等 Shingle。 -
MinHash 签名生成:Zilliz Cloud 会将多个哈希函数(H1、H2、...、Hn,其中
n = num_hashes)应用到 Shingle 集合。对于每个哈希函数,Zilliz Cloud 会选取所有 Shingle 哈希值中的最小值。所有最小值共同组成 MinHash 签名,用于以固定长度表示原始文档的近似 Jaccard 相似度。 -
二进制向量编码:每个签名值都是 32-bit 哈希值,完整签名会被打包为维度为
32 * num_hashes的BINARY_VECTOR。
文档写入
写入数据时,共享流水线生成的二进制向量会存储在 MINHASH_LSH 索引中。该索引维护 LSH(Locality-Sensitive Hashing)表,将相似签名分组到相同 Bucket 中,从而在查询时快速检索候选文档。
查询处理
查询时,查询文本会通过同一套共享流水线生成二进制向量。该向量用于在 MINHASH_LSH 索引中执行 LSH 查找,识别可能相似的候选文档,并返回对应的 MHJACCARD 分数。
由于写入和查询路径使用相同的转换逻辑,具有大量 Shingle 重叠的两个文档会生成相似的 MinHash 签名。因此,MinHash Function 适合在存在轻微格式差异或措辞差异时查找近重复文档。
开始前
使用 MinHash Function 前,请规划 Collection Schema,使其包含以下内容:
-
用于存储原始内容的文本字段
Collection 必须包含一个 VARCHAR 字段,用于存储原始文本。该字段作为 MinHash Function 的输入字段。
-
文本字段的 Analyzer(使用词级别 Tokenization 时)
如果
token_level设置为"word"(默认值),文本字段必须启用 Analyzer。Analyzer 定义文本在 Shingling 前的分词方式。默认情况下,Zilliz Cloud 使用 standard Analyzer。要配置其他 Analyzer,请参考最佳实践:如何选择合适的 Analyzer。 -
用于存储 MinHash 输出的二进制向量字段
Collection 必须包含一个
BINARY_VECTOR字段,用于存储 MinHash Function 生成的二进制向量。该字段的维度必须等于32 * num_hashes。
第 1 步:创建带有 MinHash Function 的 Collection
要使用 MinHash Function,请在创建 Collection 时定义 Function。该 Function 会成为 Collection Schema 的一部分,并在数据写入和查询时自动生效。
定义 Schema 字段
Collection Schema 至少需要包含以下三个字段:
-
主键字段:唯一标识 Collection 中的每个 Entity。
-
文本字段(
VARCHAR):存储原始文本文档。设置enable_analyzer=True,使 Zilliz Cloud 能够处理文本并生成 MinHash 签名。默认情况下,Zilliz Cloud 使用 standard Analyzer 进行文本分析。要配置其他 Analyzer,请参考最佳实践:如何选择合适的 Analyzer。 -
二进制向量字段(
BINARY_VECTOR):存储 MinHash Function 自动生成的二进制向量。该字段的维度必须等于32 * num_hashes。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
from pymilvus import MilvusClient, DataType, Function, FunctionType

client = MilvusClient(uri="YOUR_CLUSTER_ENDPOINT", token="YOUR_CLUSTER_TOKEN")

schema = client.create_schema()

schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True, auto_id=True)
schema.add_field(field_name="document_content", datatype=DataType.VARCHAR, max_length=9000, enable_analyzer=True)
schema.add_field(field_name="binary_vector", datatype=DataType.BINARY_VECTOR, dim=8192)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN")
        .build());

CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder().build();
schema.addField(AddFieldReq.builder()
        .fieldName("id")
        .dataType(DataType.Int64)
        .isPrimaryKey(true)
        .autoID(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("document_content")
        .dataType(DataType.VarChar)
        .maxLength(9000)
        .enableAnalyzer(true)
        .build());
schema.addField(AddFieldReq.builder()
        .fieldName("binary_vector")
        .dataType(DataType.BinaryVector)
        .dimension(8192)
        .build());
import (
    "context"
    "log"

    "github.com/milvus-io/milvus/client/v3/entity"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

ctx := context.Background()
client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: "YOUR_CLUSTER_ENDPOINT",
    APIKey:  "YOUR_CLUSTER_TOKEN",
})
if err != nil {
    log.Fatal(err)
}

schema := entity.NewSchema().
    WithField(entity.NewField().WithName("id").WithDataType(entity.FieldTypeInt64).WithIsPrimaryKey(true).WithIsAutoID(true)).
    WithField(entity.NewField().WithName("document_content").WithDataType(entity.FieldTypeVarChar).WithMaxLength(9000).WithEnableAnalyzer(true)).
    WithField(entity.NewField().WithName("binary_vector").WithDataType(entity.FieldTypeBinaryVector).WithDim(8192))
use milvus::v2::prelude::*;

let config = ConnectConfig::new().uri("YOUR_CLUSTER_ENDPOINT");
let client = ClientV2::new(&config).await?;

let schema = CollectionSchema::new()
    .add_field(FieldSchema::new().name("id").data_type(DataType::Int64).primary_key(true).auto_id(true))
    .add_field(FieldSchema::new().name("document_content").data_type(DataType::VarChar).max_length(9000).enable_analyzer(true))
    .add_field(FieldSchema::new().name("binary_vector").data_type(DataType::BinaryVector).dimension(8192));
#include "milvus/MilvusClientV2.h"
#include <iostream>

auto client = milvus::MilvusClientV2::Create();
milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

auto schema = std::make_shared<milvus::CollectionSchema>();
schema->AddField(milvus::FieldSchema("id", milvus::DataType::INT64).WithPrimaryKey(true).WithAutoID(true));
schema->AddField(milvus::FieldSchema("document_content", milvus::DataType::VARCHAR).WithMaxLength(9000).EnableAnalyzer(true));
schema->AddField(milvus::FieldSchema("binary_vector", milvus::DataType::BINARY_VECTOR).WithDimension(8192));
import { MilvusClient, DataType, FunctionType, IndexType, MetricType } from "@zilliz/milvus2-sdk-node";

const client = new MilvusClient({ address: "YOUR_CLUSTER_ENDPOINT", token: "YOUR_CLUSTER_TOKEN" });

const fields = [
  { name: "id", data_type: DataType.Int64, is_primary_key: true, autoID: true },
  { name: "document_content", data_type: DataType.VarChar, max_length: 9000, enable_analyzer: true },
  { name: "binary_vector", data_type: DataType.BinaryVector, dim: 8192 },
];
using Milvus.Client.V2;
using Milvus.Client.V2.Types;

MilvusClientV2 client = new(new ConnectConfig
{
    Uri = "YOUR_CLUSTER_ENDPOINT",
    Username = "root",
    Password = "Milvus"
});

CollectionSchema schema = new()
{
    Fields =
    {
        new FieldSchema("id", DataType.Int64, isPrimaryKey: true, autoId: true),
        FieldSchema.CreateVarchar("document_content", 9000, enableAnalyzer: true),
        new FieldSchema("binary_vector", DataType.BinaryVector) { Dimension = 8192 }
    }
};
fields='[
  {"fieldName": "id", "dataType": "Int64", "isPrimary": true},
  {"fieldName": "document_content", "dataType": "VarChar", "elementTypeParams": {"max_length": 9000, "enable_analyzer": true}},
  {"fieldName": "binary_vector", "dataType": "BinaryVector", "elementTypeParams": {"dim": 8192}}
]'
定义 MinHash Function
MinHash Function 会将分析后的文本转换为二进制向量,用于近似表示文档之间的 Jaccard 相似度。
定义 Function 并将其添加到 Schema 中:
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
minhash_function = Function(
    name="minhash_function",
    input_field_names=["document_content"], # Name of the VARCHAR field containing raw text
    output_field_names=["binary_vector"], # Name of the BINARY_VECTOR field for generated signatures
    function_type=FunctionType.MINHASH,
    params={
        "num_hashes": 256, # Number of hash functions; produces dim = 32 * 256 = 8192
        "shingle_size": 3, # N-gram size for shingling
    }
)

schema.add_function(minhash_function)
import io.milvus.common.clientenum.FunctionType;
import io.milvus.v2.service.collection.request.CreateCollectionReq;
import java.util.Collections;

schema.addFunction(CreateCollectionReq.Function.builder()
        .name("minhash_function")
        .functionType(FunctionType.MINHASH)
        .inputFieldNames(Collections.singletonList("document_content"))
        .outputFieldNames(Collections.singletonList("binary_vector"))
        .param("num_hashes", "256")
        .param("shingle_size", "3")
        .build());
import "github.com/milvus-io/milvus/client/v3/entity"

function := entity.NewFunction().
    WithName("minhash_function").
    WithType(entity.FunctionTypeMinHash).
    WithInputFields("document_content").
    WithOutputFields("binary_vector").
    WithParam("num_hashes", "256").
    WithParam("shingle_size", "3")

schema = schema.WithFunction(function)
use milvus::v2::prelude::*;

let schema = schema.add_function(
    Function::new()
        .name("minhash_function")
        .function_type(FunctionType::MinHash)
        .input_fields(vec!["document_content"])
        .output_fields(vec!["binary_vector"])
        .param("num_hashes", "256")
        .param("shingle_size", "3"),
);
auto function = std::make_shared<milvus::Function>("minhash_function", milvus::FunctionType::MINHASH);
function->AddInputFieldName("document_content");
function->AddOutputFieldName("binary_vector");
function->AddParam("num_hashes", "256");
function->AddParam("shingle_size", "3");
schema->AddFunction(function);
import { FunctionType } from "@zilliz/milvus2-sdk-node";

const functions = [
  {
    name: "minhash_function",
    type: FunctionType.MINHASH,
    input_field_names: ["document_content"],
    output_field_names: ["binary_vector"],
    params: { num_hashes: 256, shingle_size: 3 },
  },
];
using Milvus.Client.V2.Types;

// Note: milvus-sdk-csharp as of v3.0.0 cannot set MinHash function params
// (num_hashes / shingle_size) — FunctionSchema.Params is not publicly settable;
// the server defaults are used.
FunctionSchema minhashFunction = new(
    "minhash_function",
    FunctionType.MinHash,
    ["document_content"], // Name of the VARCHAR field containing raw text
    ["binary_vector"]);   // Name of the BINARY_VECTOR field for generated signatures

schema.Functions.Add(minhashFunction);
function='{
  "name": "minhash_function",
  "type": "MinHash",
  "inputFieldNames": ["document_content"],
  "outputFieldNames": ["binary_vector"],
  "params": {"num_hashes": 256, "shingle_size": 3}
}'
配置选项
MinHash Function 的 params 字典支持以下参数。所有参数名都不区分大小写。
参数 | 类型 | 默认值 | 说明 |
|---|---|---|---|
| int | 从 | 用于签名生成的哈希函数数量。输出二进制向量维度等于 |
| int |
| Shingling 使用的 n-gram 大小。词级别通常使用 1-3;字符级别通常使用 2-6。 |
| str |
| 使用的哈希函数。可选值:
|
| str |
| Tokenization 级别。可选值:
词级别语义更强、效率更高,但依赖语言相关的分词;字符级别与语言无关,但会生成更高维的 Shingle,语义较弱。 |
| int |
| MinHash Function 初始化使用的随机种子。 |
配置索引
MinHash 二进制向量推荐使用 MINHASH_LSH 索引,Metric Type 为 MHJACCARD。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="binary_vector",
    index_type="MINHASH_LSH",
    metric_type="MHJACCARD",
    params={
        "mh_lsh_band": 128,
        "mh_element_bit_width": 32,
        "with_raw_data": True,
    },
)
import io.milvus.v2.common.IndexParam;
import java.util.HashMap;

IndexParam indexParam = IndexParam.builder()
        .fieldName("binary_vector")
        .indexType(IndexParam.IndexType.MINHASH_LSH)
        .metricType(IndexParam.MetricType.MHJACCARD)
        .extraParams(new HashMap<String, Object>() {{
            put("mh_lsh_band", 128);
            put("mh_element_bit_width", 32);
            put("with_raw_data", true);
        }})
        .build();
import (
    "github.com/milvus-io/milvus/client/v3/entity"

    "github.com/milvus-io/milvus/client/v3/index"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

indexOption := milvusclient.NewCreateIndexOption("dedup_collection", "binary_vector", index.NewMinHashLSHIndex(entity.MHJACCARD, 128).
    WithElementBitWidth(32).
    WithRawData(true)).
    WithIndexName("minhash_index")
use milvus::v2::prelude::*;
use std::collections::HashMap;

let index_param = IndexParam::new()
    .field_name("binary_vector")
    .index_name("minhash_index")
    .index_type(IndexType::MinhashLsh)
    .metric_type(MetricType::MhJaccard)
    .extra_params(HashMap::from([
        ("mh_lsh_band".to_string(), "128".to_string()),
        ("mh_element_bit_width".to_string(), "32".to_string()),
        ("with_raw_data".to_string(), "true".to_string()),
    ]));
milvus::IndexDesc index("binary_vector", "minhash_index", milvus::IndexType::MINHASH_LSH, milvus::MetricType::MHJACCARD);
index.AddExtraParam("mh_lsh_band", "128");
index.AddExtraParam("mh_element_bit_width", "32");
index.AddExtraParam("with_raw_data", "true");
import { IndexType, MetricType } from "@zilliz/milvus2-sdk-node";

const indexParam = {
  field_name: "binary_vector",
  index_type: IndexType.MINHASH_LSH,
  metric_type: MetricType.MHJACCARD,
  params: { mh_lsh_band: 128, mh_element_bit_width: 32, with_raw_data: true },
};
using Milvus.Client.V2.Types;

IndexParam indexParam = new("binary_vector", "minhash_index", IndexType.MinHashLsh, MetricType.MhJaccard)
{
    ExtraParams =
    {
        ["mh_lsh_band"] = 128,
        ["mh_element_bit_width"] = 32,
        ["with_raw_data"] = true
    }
};
indexParams='[
  {"fieldName": "binary_vector", "indexType": "MINHASH_LSH", "metricType": "MHJACCARD", "params": {"mh_lsh_band": 128, "mh_element_bit_width": 32, "with_raw_data": true}}
]'
创建 Collection
使用上面定义的 Schema 和索引参数创建 Collection:
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
client.create_collection(
    collection_name="dedup_collection",
    schema=schema,
    index_params=index_params,
)
import io.milvus.v2.service.collection.request.CreateCollectionReq;
import java.util.Collections;

client.createCollection(CreateCollectionReq.builder()
        .collectionName("dedup_collection")
        .collectionSchema(schema)
        .indexParams(Collections.singletonList(indexParam))
        .build());
import (
    "log"

    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

err = client.CreateCollection(ctx, milvusclient.NewCreateCollectionOption("dedup_collection", schema).
    WithIndexOptions(indexOption))
if err != nil {
    log.Fatal(err)
}
use milvus::v2::prelude::*;

client.create_collection(CreateCollectionRequest::builder()
    .collection_name("dedup_collection")
    .schema(schema)
    .index_params(vec![index_param])
    .build()?)
.await?;
status = client->CreateCollection(milvus::CreateCollectionRequest()
                                 .WithCollectionName("dedup_collection")
                                 .WithCollectionSchema(schema));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
await client.createCollection({
  collection_name: "dedup_collection",
  fields: fields,
  functions: functions,
});

await client.createIndex({
  collection_name: "dedup_collection",
  ...indexParam,
});
using Milvus.Client.V2.Requests.Collection;

await client.CreateCollectionAsync(new CreateCollectionReq
{
    CollectionName = "dedup_collection",
    Schema = schema,
    Indexes = [indexParam]
});
export CLUSTER_ENDPOINT="YOUR_CLUSTER_ENDPOINT"
export TOKEN="YOUR_CLUSTER_TOKEN"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
-d '{
    "collectionName": "dedup_collection",
    "schema": {
        "fields": [
            {"fieldName": "id", "dataType": "Int64", "isPrimary": true},
            {"fieldName": "document_content", "dataType": "VarChar", "elementTypeParams": {"max_length": 9000, "enable_analyzer": true}},
            {"fieldName": "binary_vector", "dataType": "BinaryVector", "elementTypeParams": {"dim": 8192}}
        ],
        "functions": [
            {"name": "minhash_function", "type": "MinHash", "inputFieldNames": ["document_content"], "outputFieldNames": ["binary_vector"], "params": {"num_hashes": 256, "shingle_size": 3}}
        ],
        "autoID": true
    },
    "indexParams": [
        {"fieldName": "binary_vector", "indexType": "MINHASH_LSH", "metricType": "MHJACCARD", "params": {"mh_lsh_band": 128, "mh_element_bit_width": 32, "with_raw_data": true}}
    ]
}'
第 2 步:插入文档
Collection 创建完成后,插入文本数据。您只需要提供原始文本,MinHash Function 会为每个文档自动生成二进制向量。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
client.insert(
    "dedup_collection",
    [
        {"document_content": "information retrieval is a field of study that helps users find relevant information in large datasets"},
        {"document_content": "information retrieval is a research field focused on helping users find relevant data in large collections"},
        {"document_content": "information retrieval is a field of research helping users search for relevant information in large datasets"},
    ],
)
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;
import java.util.ArrayList;
import java.util.List;

List<JsonObject> data = new ArrayList<>();

JsonObject row1 = new JsonObject();
row1.addProperty("document_content", "information retrieval is a field of study that helps users find relevant information in large datasets");
data.add(row1);

JsonObject row2 = new JsonObject();
row2.addProperty("document_content", "information retrieval is a research field focused on helping users find relevant data in large collections");
data.add(row2);

JsonObject row3 = new JsonObject();
row3.addProperty("document_content", "information retrieval is a field of research helping users search for relevant information in large datasets");
data.add(row3);

client.insert(InsertReq.builder()
        .collectionName("dedup_collection")
        .data(data)
        .build());
import (
    "log"

    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("dedup_collection").
    WithVarcharColumn("document_content", []string{
        "information retrieval is a field of study that helps users find relevant information in large datasets",
        "information retrieval is a research field focused on helping users find relevant data in large collections",
        "information retrieval is a field of research helping users search for relevant information in large datasets",
    }))
if err != nil {
    log.Fatal(err)
}
use milvus::v2::prelude::*;
use serde_json::json;

let insert_req = InsertRequest::builder()
    .collection_name("dedup_collection")
    .rows(vec![
        json!({"document_content": "information retrieval is a field of study that helps users find relevant information in large datasets"}),
        json!({"document_content": "information retrieval is a research field focused on helping users find relevant data in large collections"}),
        json!({"document_content": "information retrieval is a field of research helping users search for relevant information in large datasets"}),
    ])
    .build()?;

client.insert(insert_req).await?;
milvus::EntityRows rows;
rows.emplace_back(milvus::EntityRow{{"document_content", "information retrieval is a field of study that helps users find relevant information in large datasets"}});
rows.emplace_back(milvus::EntityRow{{"document_content", "information retrieval is a research field focused on helping users find relevant data in large collections"}});
rows.emplace_back(milvus::EntityRow{{"document_content", "information retrieval is a field of research helping users search for relevant information in large datasets"}});

milvus::InsertResponse insert_response;
status = client->Insert(milvus::InsertRequest()
                            .WithCollectionName("dedup_collection")
                            .WithRowsData(std::move(rows)),
                        insert_response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
await client.insert({
  collection_name: "dedup_collection",
  data: [
    { document_content: "information retrieval is a field of study that helps users find relevant information in large datasets" },
    { document_content: "information retrieval is a research field focused on helping users find relevant data in large collections" },
    { document_content: "information retrieval is a field of research helping users search for relevant information in large datasets" },
  ],
});
using Milvus.Client.V2.Requests.Dml;

await client.InsertAsync(new InsertReq
{
    CollectionName = "dedup_collection",
    RowsData =
    [
        new Dictionary<string, object?> { ["document_content"] = "information retrieval is a field of study that helps users find relevant information in large datasets" },
        new Dictionary<string, object?> { ["document_content"] = "information retrieval is a research field focused on helping users find relevant data in large collections" },
        new Dictionary<string, object?> { ["document_content"] = "information retrieval is a field of research helping users search for relevant information in large datasets" }
    ]
});
export CLUSTER_ENDPOINT="YOUR_CLUSTER_ENDPOINT"
export TOKEN="YOUR_CLUSTER_TOKEN"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
-d '{
    "collectionName": "dedup_collection",
    "data": [
        {"document_content": "information retrieval is a field of study that helps users find relevant information in large datasets"},
        {"document_content": "information retrieval is a research field focused on helping users find relevant data in large collections"},
        {"document_content": "information retrieval is a field of research helping users search for relevant information in large datasets"}
    ]
}'
第 3 步:使用 MinHash 搜索
插入数据后,您可以通过提供原始文本查询来搜索近重复文档。Zilliz Cloud 会自动将查询文本转换为 MinHash 二进制向量,并返回带有 MHJACCARD 分数的候选文档。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- CSharp
- cURL
search_params = {
    "metric_type": "MHJACCARD",
    "params": {
        "mh_search_with_jaccard": True,
        "refine_k": 3,
    },
}

results = client.search(
    collection_name="dedup_collection",
    data=["information retrieval is a research field focused on helping users find relevant data in large collections"],
    anns_field="binary_vector",
    limit=3,
    output_fields=["document_content"],
    search_params=search_params,
)

for hits in results:
    for hit in hits:
        print(f"ID: {hit['id']}, Distance: {hit['distance']}")
        print(f"Document: {hit['entity']['document_content']}")
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.request.data.EmbeddedText;
import io.milvus.v2.service.vector.response.SearchResp;
import io.milvus.v2.common.IndexParam;
import java.util.Arrays;
import java.util.Collections;
import java.util.HashMap;

SearchResp resp = client.search(SearchReq.builder()
        .collectionName("dedup_collection")
        .annsField("binary_vector")
        .data(Collections.singletonList(new EmbeddedText("information retrieval is a research field focused on helping users find relevant data in large collections")))
        .metricType(IndexParam.MetricType.MHJACCARD)
        .searchParams(new HashMap<String, Object>() {{
            put("mh_search_with_jaccard", true);
            put("refine_k", 3);
        }})
        .limit(3)
        .outputFields(Collections.singletonList("document_content"))
        .build());

for (SearchResp.SearchResult hit : resp.getSearchResults().get(0)) {
    System.out.println("ID: " + hit.getEntity().get("id") + ", Distance: " + hit.getScore());
    System.out.println("Document: " + hit.getEntity().get("document_content"));
}
import (
    "fmt"
    "log"

    "github.com/milvus-io/milvus/client/v3/entity"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

results, err := client.Search(ctx, milvusclient.NewSearchOption(
    "dedup_collection", 3,
    []entity.Vector{entity.Text("information retrieval is a research field focused on helping users find relevant data in large collections")}).
    WithANNSField("binary_vector").
    WithOutputFields("document_content").
    WithSearchParam("metric_type", "MHJACCARD").
    WithSearchParam("mh_search_with_jaccard", "true").
    WithSearchParam("refine_k", "3"))
if err != nil {
    log.Fatal(err)
}

for _, rs := range results {
    fmt.Printf("ID: %v, Distance: %v\n", rs.IDs, rs.Scores)
}
use milvus::v2::prelude::*;
use std::collections::HashMap;

let search_req = SearchRequest::builder()
    .collection_name("dedup_collection")
    .vector_field("binary_vector")
    .vectors(SearchVectors::EmbeddedText(vec!["information retrieval is a research field focused on helping users find relevant data in large collections".to_string()]))
    .metric_type(MetricType::MhJaccard)
    .extra_params(HashMap::from([
        ("mh_search_with_jaccard".to_string(), "true".to_string()),
        ("refine_k".to_string(), "3".to_string()),
    ]))
    .output_fields(vec!["document_content"])
    .limit(3)
    .build()?;

let res = client.search(search_req).await?;
println!("{:?}", res.results());
milvus::SearchResponse response;
status = client->Search(milvus::SearchRequest()
                            .WithCollectionName("dedup_collection")
                            .WithAnnsField("binary_vector")
                            .AddEmbeddedText("information retrieval is a research field focused on helping users find relevant data in large collections")
                            .WithMetricType(milvus::MetricType::MHJACCARD)
                            .AddExtraParam("mh_search_with_jaccard", "true")
                            .AddExtraParam("refine_k", "3")
                            .WithLimit(3)
                            .AddOutputField("document_content"),
                        response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
const results = await client.search({
  collection_name: "dedup_collection",
  anns_field: "binary_vector",
  data: ["information retrieval is a research field focused on helping users find relevant data in large collections"],
  output_fields: ["document_content"],
  search_params: {
    metric_type: "MHJACCARD",
    topk: 3,
    params: JSON.stringify({ mh_search_with_jaccard: true, refine_k: 3 }),
  },
});
console.log(results);
// Note: Refined MinHash search (`mh_search_with_jaccard` / `refine_k`) is not
// supported in milvus-sdk-csharp as of v3.0.0 — search params are string-typed,
// and the server rejects the string form for MINHASH refinement.
export CLUSTER_ENDPOINT="YOUR_CLUSTER_ENDPOINT"
export TOKEN="YOUR_CLUSTER_TOKEN"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
-d '{
    "collectionName": "dedup_collection",
    "annsField": "binary_vector",
    "data": ["information retrieval is a research field focused on helping users find relevant data in large collections"],
    "limit": 3,
    "outputFields": ["document_content"],
    "searchParams": {"metric_type": "MHJACCARD", "params": {"mh_search_with_jaccard": true, "refine_k": 3}}
}'
下一步
-
Full Text Search:使用 BM25 进行词法相关性排序,而不是近重复检测。
-
Analyzer 概述:配置用于文本分词的自定义 Analyzer。
-
MINHASH_LSH:了解如何调整 LSH 参数以平衡召回率和性能。