MINHASH_LSH
对于大规模机器学习数据集而言,高效的去重和相似度搜索至关重要,尤其是在清洗用于训练大语言模型(LLM)的语料库等场景中。当面对数百万乃至数十亿规模的文档时,传统的精确匹配方法往往因速度过慢、成本过高而难以适用。
Zilliz Cloud 中的 MINHASH_LSH 索引通过结合两种强大的技术,实现了快速、可扩展且准确的近似去重:
-
MinHash:快速生成紧凑的签名("指纹")以估算文档间的相似度。
-
局部敏感哈希(LSH):基于 MinHash 签名快速找出相似文档的集合。
本指南介绍在 Zilliz Cloud 中使用 MINHASH_LSH 的相关概念、前提条件、配置步骤以及最佳实践。
概览
展开了解 MinHash LSH 工作原理
Jaccard 相似度
Jaccard 相似度用于衡量两个集合 A 和 B 之间的重叠程度,其正式定义为:
其取值范围为 0(完全不相交)到 1(完全相同)。
但在大规模数据集中,精确计算所有文档对之间的 Jaccard 相似度在时间和内存开销上都是 O(n²) 级别的,当 n 较大时,这种开销变得不可承受。因此,该方法在 LLM 训练语料清洗或网页级文档分析等场景中难以使用。
MinHash 签名:近似 Jaccard 相似度
MinHash 是一种概率技术,能够高效地估算 Jaccard 相似度。它将每个集合转换为一个紧凑的签名向量,并保留足够的信息以高效近似集合间的相似度。
核心思想:
两个集合越相似,它们的 MinHash 签名在相同位置上匹配的概率就越高。这一特性使得 MinHash 能够近似估算集合间的 Jaccard 相似度。
借助这一特性,MinHash 可以近似估算 Jaccard 相似度,而无需直接比较完整的集合。
MinHash 的处理流程包括:
-
Shingling:将文档拆分为重叠的 token 序列集合(shingle)。
-
哈希:对每个 shingle 应用多个独立的哈希函数。
-
取最小值:对每个哈希函数,记录所有 shingle 哈希值中的最小值。
完整过程如下图所示:
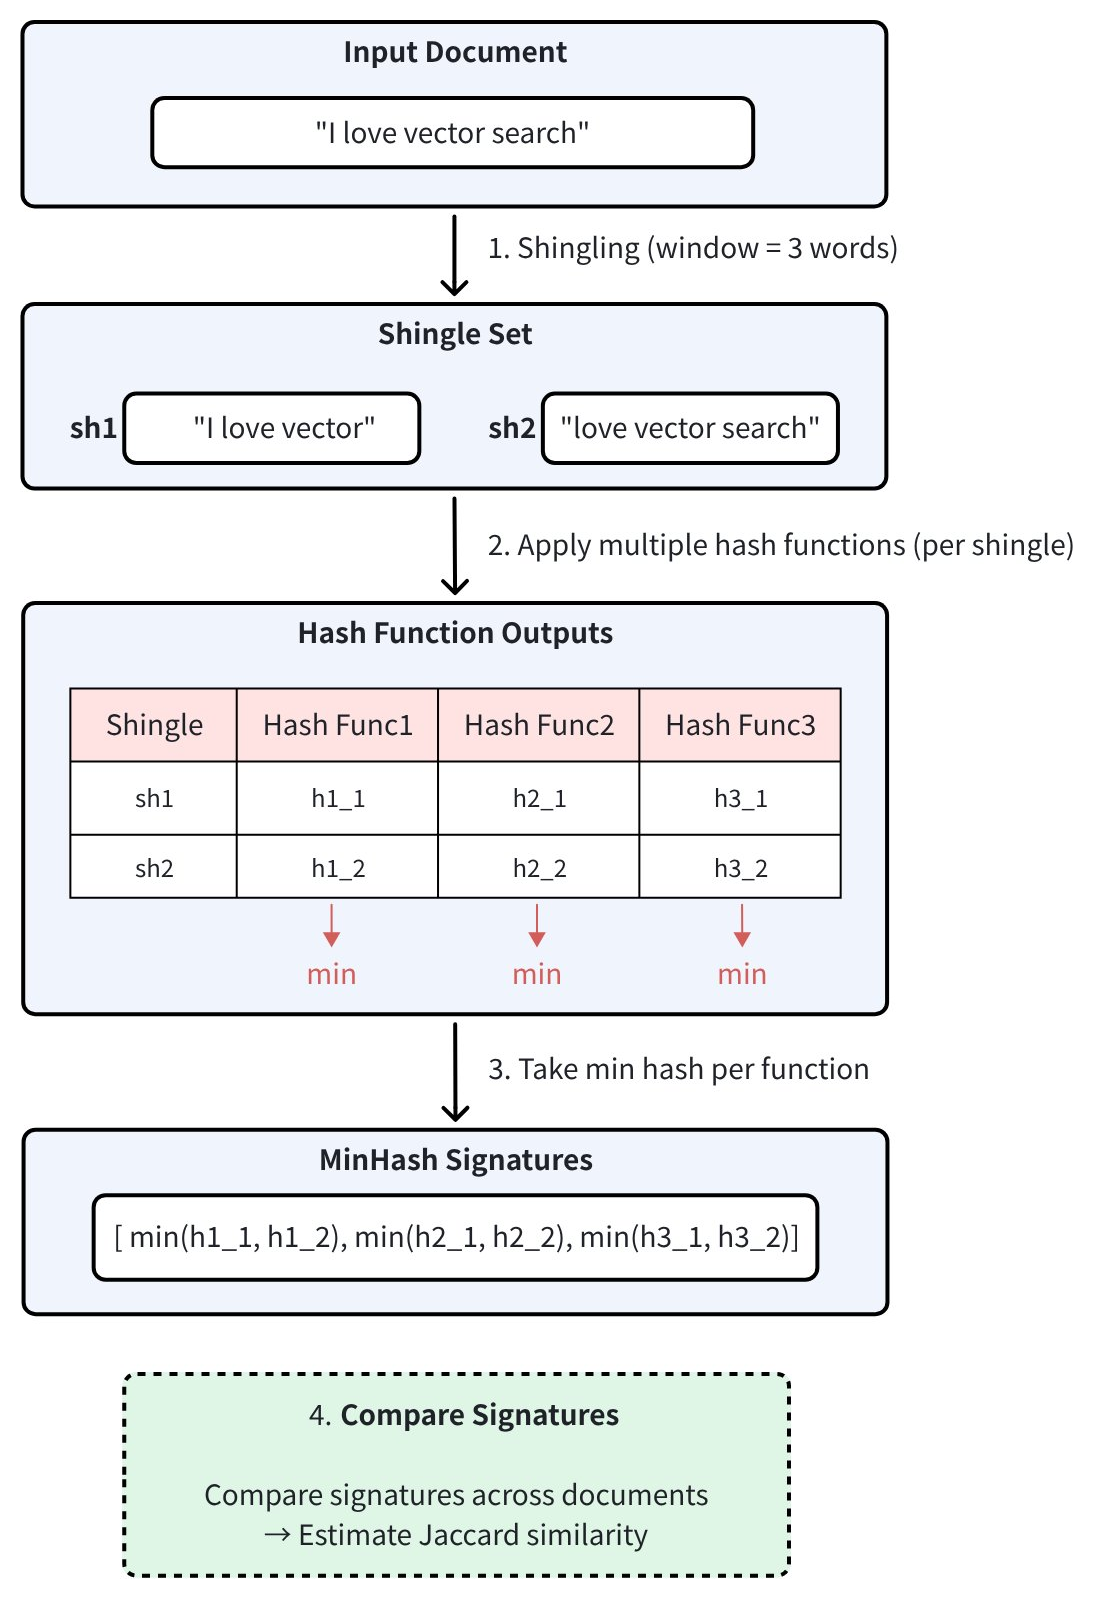
所使用的哈希函数数量决定了 MinHash 签名的维度。维度越高,近似精度越好,但相应的存储和计算成本也会增加。
MinHash 的 LSH
虽然 MinHash 签名显著降低了精确计算文档间 Jaccard 相似度的开销,但在大规模数据下逐一比较所有签名向量仍然效率低下。
为了解决这一问题,可以使用 LSH。LSH 通过让相似项以高概率被哈希到同一个"桶"中,从而实现快速的近似相似度搜索,避免对所有项进行两两比较。
具体流程如下:
-
签名分段:
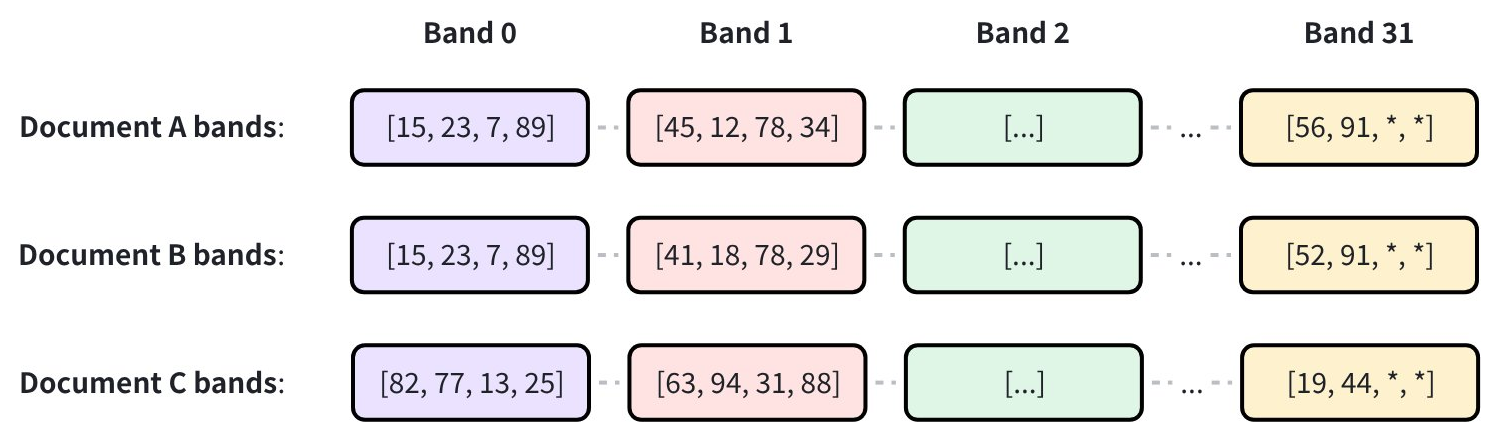
一个 n 维 MinHash 签名被划分为 b 个 band,每个 band 包含 r 个连续的哈希值,因此签名总长度满足:n = b × r。
例如,一个 128 维的 MinHash 签名(n = 128)被划分为 32 个 band(b = 32),则每个 band 包含 4 个哈希值(r = 4)。
-
band 级哈希:
分段完成后,每个 band 都通过一个标准哈希函数独立处理,被分配到一个桶中。如果两个签名在某个 band 内产生了相同的哈希值——即落入同一个桶——它们就被视为潜在的匹配项。
-
候选筛选:
在至少一个 band 上发生碰撞的签名对会被选为相似性候选。
它为什么有效?
从数学角度看,如果两个签名的 Jaccard 相似度为 :
-
它们在某一行(哈希位置)上相同的概率为
-
它们在一个 band 的全部 rr 行上都匹配的概率为
-
它们在至少一个 band 上匹配的概率为 $1 - (1 - s^r)^b$
更多详情请参考 Locality-sensitive hashing。
以三个具有 128 维 MinHash 签名的文档为例:
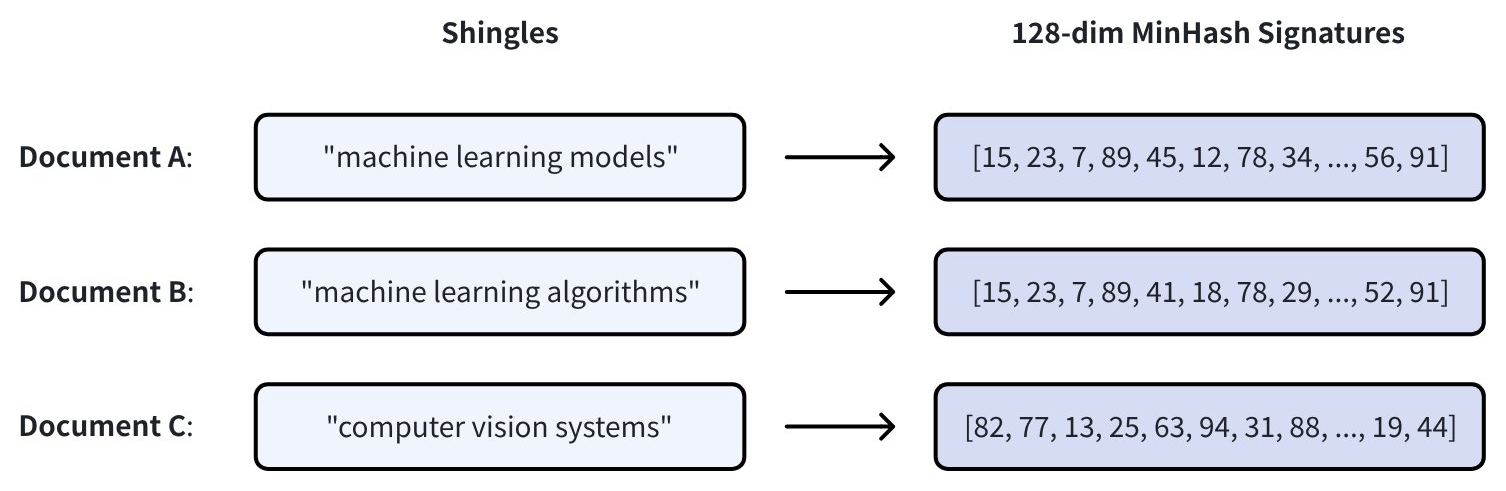
首先,LSH 将 128 维签名划分为 32 个 band,每个 band 包含 4 个连续的值:
接着,每个 band 通过哈希函数被分配到不同的桶中。共享同一个桶的文档对会被选为相似性候选。在下例中,文档 A 和文档 B 在 Band 0 上的哈希结果发生碰撞,因此被选为相似性候选:
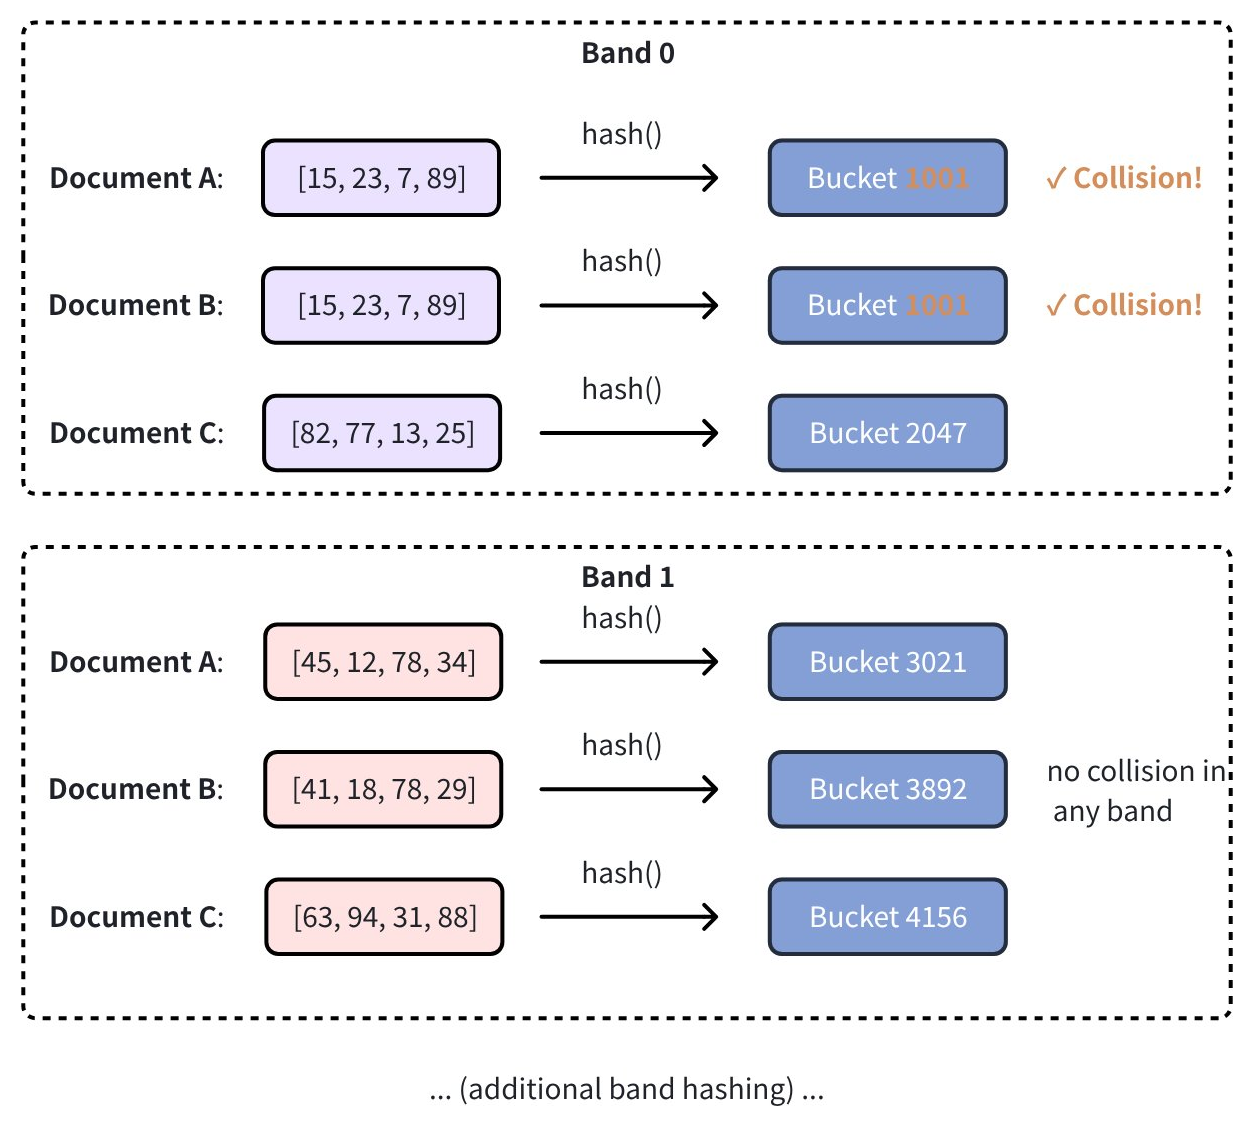
band 的数量由 mh_lsh_band 参数控制。更多信息请参见索引构建参数。
MHJACCARD:比较 MinHash 签名
MinHash 签名通过固定长度的二进制向量来近似集合间的 Jaccard 相似度。但由于这些签名并不保留原始集合,因此无法直接使用 JACCARD、L2 或 COSINE 等标准度量来比较它们。
为此,Zilliz Cloud 引入了一种专门用于比较 MinHash 签名的度量类型 MHJACCARD。
在 Zilliz Cloud 中使用 MinHash 时:
-
向量字段类型必须为
BINARY_VECTOR -
index_type必须为MINHASH_LSH(或BIN_FLAT) -
metric_type必须设置为MHJACCARD
使用其他度量类型要么无效,要么会得到错误的结果。
关于该度量类型的更多信息,请参考 MHJACCARD。
去重工作流程
借助 MinHash LSH 实现的去重流程,使 Zilliz Cloud 能够在将数据写入 Collection 之前,高效识别并过滤掉近似重复的文本或结构化记录。
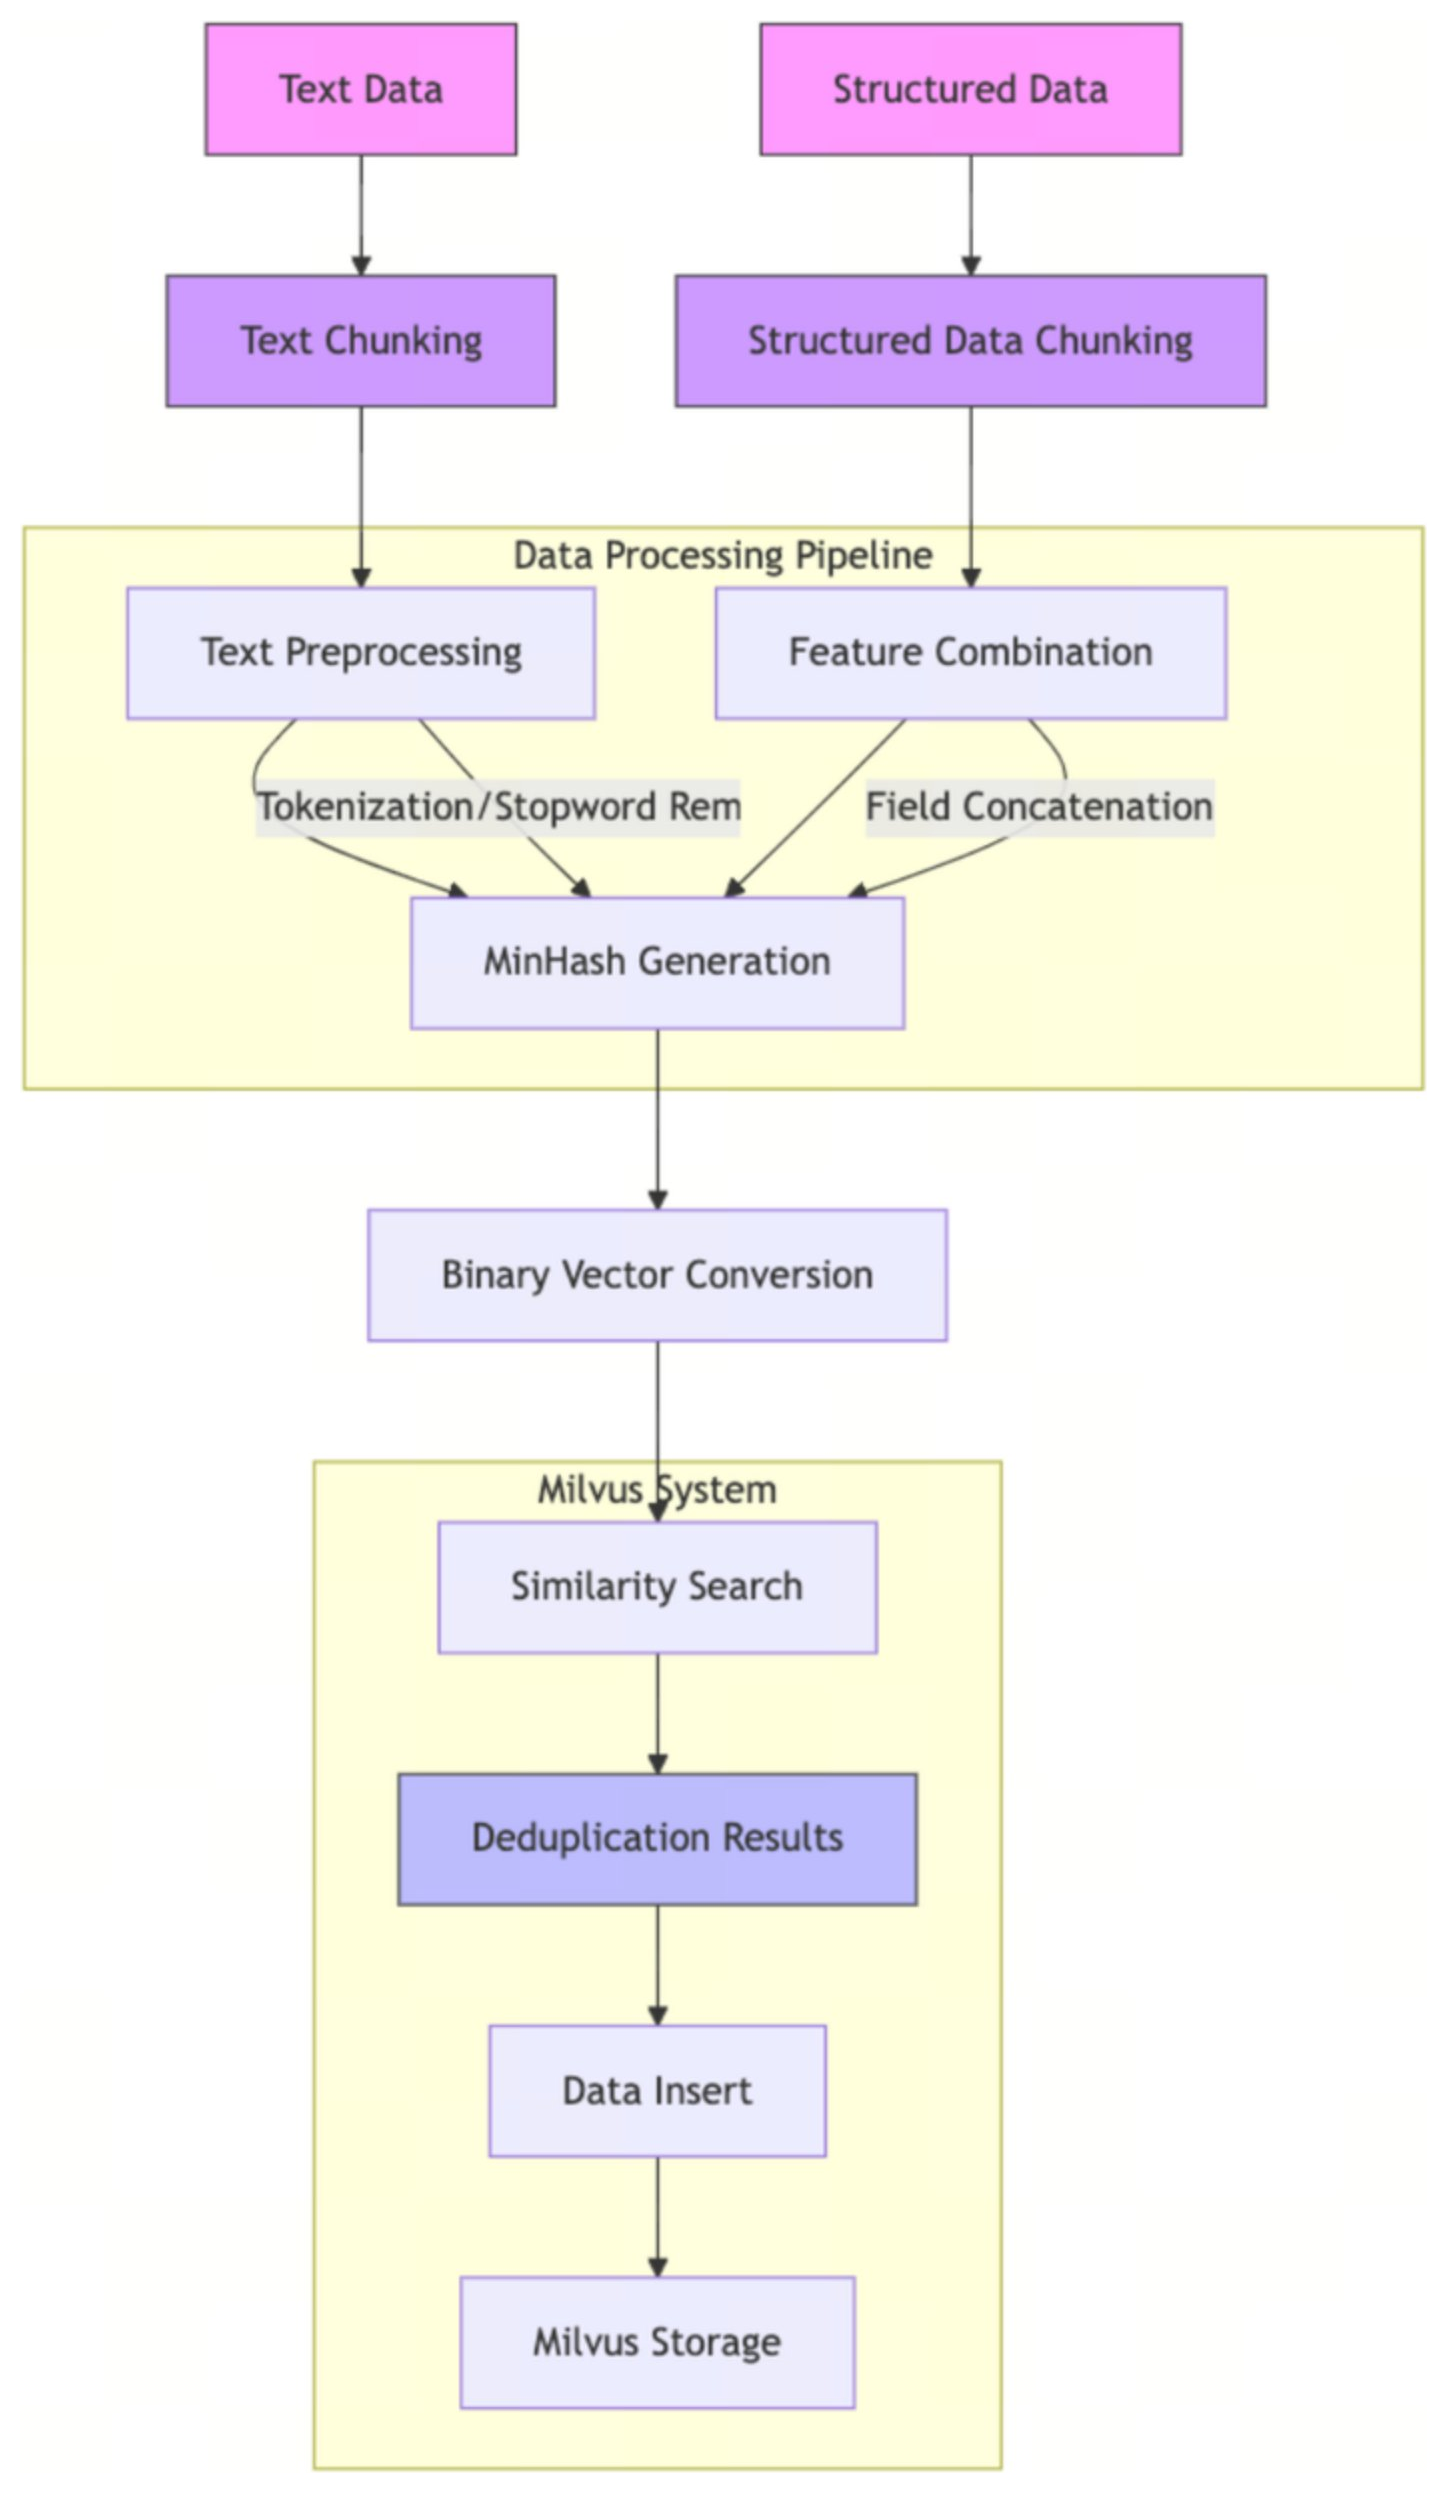
-
切分与预处理:将输入文本数据或结构化数据(例如记录、字段)切分为多个块;对文本进行规范化处理(转小写、去除标点),并根据需要去除停用词。
-
特征构造:构造用于 MinHash 的 token 集合(例如文本的 shingle;结构化数据中字段拼接得到的 token)。
-
MinHash 签名生成:为每个块或记录计算 MinHash 签名。
-
二进制向量转换:将签名转换为与 Zilliz Cloud 兼容的二进制向量。
-
先搜后插:使用 MinHash LSH 索引在目标 Collection 中搜索与待插入项近似重复的数据。
-
写入与存储:仅将不重复的数据写入 Collection,使其在后续去重检查中可被搜索。
前提条件
在 Zilliz Cloud 中使用 MinHash LSH 之前,您必须先生成 MinHash 签名。这些紧凑的二进制签名用于近似集合间的 Jaccard 相似度,是在 Zilliz Cloud 中执行基于 MHJACCARD 的搜索所必需的输入。
为 MINHASH_LSH 索引准备 MinHash 签名有两种方式:
-
使用外部工具自行生成签名,并写入 BINARY_VECTOR 字段;或
-
使用内置的 MinHash 函数自动从文本生成兼容的二进制向量。关于 MinHash 函数的端到端工作流程和配置选项,请参考 MinHash Function。
选择 MinHash 签名的生成方式
您可以根据自身工作负载来选择合适的生成方式:
-
使用 Python 的
datasketch,简单易用(推荐用于原型开发) -
使用 Spark、Ray 等分布式工具处理大规模数据集
-
在需要进行性能调优时,使用 NumPy、C++ 等实现自定义逻辑
本指南为了简洁起见,使用 datasketch 来演示,其输出格式与 Zilliz Cloud 的输入格式兼容。
安装所需依赖
安装本例所需的依赖包:
pip install pymilvus datasketch numpy
生成 MinHash 签名
我们将生成 256 维的 MinHash 签名,每个哈希值由 64 位整数表示。这与 MINHASH_LSH 期望的向量格式一致。
from datasketch import MinHash
import numpy as np

MINHASH_DIM = 256
HASH_BIT_WIDTH = 64

def generate_minhash_signature(text, num_perm=MINHASH_DIM) -> bytes:
    m = MinHash(num_perm=num_perm)
    for token in text.lower().split():
        m.update(token.encode("utf8"))
    return m.hashvalues.astype('>u8').tobytes()  # Returns 2048 bytes
每个签名的大小为 256 × 64 bit = 2048 字节。该字节串可以直接写入 BINARY_VECTOR 字段。关于 Zilliz Cloud 中使用的二进制向量的更多信息,请参考 Binary 向量。
(可选)准备原始 token 集合(用于精排搜索)
默认情况下,Zilliz Cloud 仅基于 MinHash 签名和 LSH 索引来查找近似邻居。这种方式速度很快,但可能产生误判或漏掉某些近似匹配。
如果您希望获得精确的 Jaccard 相似度,Zilliz Cloud 支持使用原始 token 集合进行精排搜索。启用方式:
-
将 token 集合存储在一个单独的
VARCHAR字段中 -
在构建索引参数时设置
"with_raw_data": True -
在执行相似度搜索时启用
"mh_search_with_jaccard": True
token 集合提取示例:
def extract_token_set(text: str) -> str:
    tokens = set(text.lower().split())
    return " ".join(tokens)
使用 MinHash LSH
当 MinHash 向量和原始 token 集合准备就绪后,您可以使用 Zilliz Cloud 的 MINHASH_LSH 来存储、索引并搜索这些数据。
连接到集群
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
from pymilvus import MilvusClient

client = MilvusClient(uri="YOUR_CLUSTER_ENDPOINT")  # Update if your URI is different
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;

ConnectConfig connectConfig = ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .build();
MilvusClientV2 client = new MilvusClientV2(connectConfig);
import (
    "context"
    "log"

    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

ctx := context.Background()

cli, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: "YOUR_CLUSTER_ENDPOINT",
})
if err != nil {
    log.Fatal(err)
}
defer cli.Close(ctx)
use milvus::v2::prelude::*;

let config = ConnectConfig::new().uri("YOUR_CLUSTER_ENDPOINT");
let client = ClientV2::new(&config).await?;
#include "milvus/MilvusClientV2.h"
#include <iostream>

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
import { MilvusClient } from '@zilliz/milvus2-sdk-node';

const client = new MilvusClient({ address: 'YOUR_CLUSTER_ENDPOINT' });
export CLUSTER_ENDPOINT="YOUR_CLUSTER_ENDPOINT"
export TOKEN="YOUR_CLUSTER_TOKEN"
定义 Collection Schema
定义包含以下字段的 schema:
-
主键
-
用于存储 MinHash 签名的
BINARY_VECTOR字段 -
用于存储原始 token 集合的
VARCHAR字段(启用精排搜索时需要) -
(可选)用于存储原始文本的
document字段
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
from pymilvus import DataType

VECTOR_DIM = MINHASH_DIM * HASH_BIT_WIDTH  # 256 × 64 = 16384 bits

schema = client.create_schema(auto_id=False, enable_dynamic_field=False)
schema.add_field("doc_id", DataType.INT64, is_primary=True)
schema.add_field("minhash_signature", DataType.BINARY_VECTOR, dim=VECTOR_DIM)
schema.add_field("token_set", DataType.VARCHAR, max_length=1000)  # required for refinement
schema.add_field("document", DataType.VARCHAR, max_length=1000)
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

int VECTOR_DIM = 256 * 64;  // 256 × 64 = 16384 bits

CreateCollectionReq.CollectionSchema schema = CreateCollectionReq.CollectionSchema.builder()
        .enableDynamicField(false)
        .build();
schema.addField(AddFieldReq.builder()
        .fieldName("doc_id").dataType(DataType.Int64).isPrimaryKey(true).build());
schema.addField(AddFieldReq.builder()
        .fieldName("minhash_signature").dataType(DataType.BinaryVector).dimension(VECTOR_DIM).build());
schema.addField(AddFieldReq.builder()
        .fieldName("token_set").dataType(DataType.VarChar).maxLength(1000).build());
schema.addField(AddFieldReq.builder()
        .fieldName("document").dataType(DataType.VarChar).maxLength(1000).build());
import (
    "github.com/milvus-io/milvus/client/v3/entity"
)

// 256 × 64 = 16384 bits
schema := entity.NewSchema().
    WithField(entity.NewField().WithName("doc_id").WithDataType(entity.FieldTypeInt64).WithIsPrimaryKey(true)).
    WithField(entity.NewField().WithName("minhash_signature").WithDataType(entity.FieldTypeBinaryVector).WithDim(256 * 64)).
    WithField(entity.NewField().WithName("token_set").WithDataType(entity.FieldTypeVarChar).WithMaxLength(1000)).
    WithField(entity.NewField().WithName("document").WithDataType(entity.FieldTypeVarChar).WithMaxLength(1000))
use milvus::v2::prelude::*;

// 256 × 64 = 16384 bits
let schema = CollectionSchema::new()
    .enable_dynamic_field(false)
    .add_field(FieldSchema::new().name("doc_id").data_type(DataType::Int64).primary_key(true))
    .add_field(FieldSchema::new().name("minhash_signature").data_type(DataType::BinaryVector).dimension(256 * 64))
    .add_field(FieldSchema::new().name("token_set").data_type(DataType::VarChar).max_length(1000))
    .add_field(FieldSchema::new().name("document").data_type(DataType::VarChar).max_length(1000));
const int VECTOR_DIM = 256 * 64;  // 256 × 64 = 16384 bits

milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
schema->AddField({"doc_id", milvus::DataType::INT64, "", true, false});
schema->AddField(milvus::FieldSchema("minhash_signature", milvus::DataType::BINARY_VECTOR).WithDimension(VECTOR_DIM));
schema->AddField(milvus::FieldSchema("token_set", milvus::DataType::VARCHAR).WithMaxLength(1000));
schema->AddField(milvus::FieldSchema("document", milvus::DataType::VARCHAR).WithMaxLength(1000));
const VECTOR_DIM = 256 * 64; // 256 × 64 = 16384 bits

const schema = [
  { name: 'doc_id', data_type: DataType.Int64, is_primary_key: true },
  { name: 'minhash_signature', data_type: DataType.BinaryVector, dim: VECTOR_DIM },
  { name: 'token_set', data_type: DataType.VarChar, max_length: 1000 },
  { name: 'document', data_type: DataType.VarChar, max_length: 1000 },
];
SCHEMA='{
  "autoId": false,
  "enableDynamicField": false,
  "fields": [
    {"fieldName": "doc_id", "dataType": "Int64", "isPrimary": true},
    {"fieldName": "minhash_signature", "dataType": "BinaryVector", "elementTypeParams": {"dim": "16384"}},
    {"fieldName": "token_set", "dataType": "VarChar", "elementTypeParams": {"max_length": "1000"}},
    {"fieldName": "document", "dataType": "VarChar", "elementTypeParams": {"max_length": "1000"}}
  ]
}'
构建索引参数并创建 Collection
构建启用了 Jaccard 精排的 MINHASH_LSH 索引:
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
index_params = client.prepare_index_params()
index_params.add_index(
    field_name="minhash_signature",
    index_type="MINHASH_LSH",
    metric_type="MHJACCARD",
    params={
        "mh_element_bit_width": HASH_BIT_WIDTH,  # Must match signature bit width
        "mh_lsh_band": 16,                       # Band count (256/16 = 16 hashes per band)
        "with_raw_data": True                    # Required for Jaccard refinement
    }
)

client.create_collection("minhash_demo", schema=schema, index_params=index_params)
import io.milvus.v2.common.IndexParam;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

import java.util.Collections;

IndexParam indexParam = IndexParam.builder()
        .fieldName("minhash_signature")
        .indexType(IndexParam.IndexType.MINHASH_LSH)
        .metricType(IndexParam.MetricType.MHJACCARD)
        .extraParams(new java.util.HashMap<String, Object>() {{
            put("mh_element_bit_width", 64);
            put("mh_lsh_band", 16);
            put("with_raw_data", true);
        }})
        .build();

client.createCollection(CreateCollectionReq.builder()
        .collectionName("minhash_demo")
        .collectionSchema(schema)
        .indexParams(Collections.singletonList(indexParam))
        .build());
import (
    "github.com/milvus-io/milvus/client/v3/entity"
    "github.com/milvus-io/milvus/client/v3/index"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

idx := index.NewMinHashLSHIndex(entity.MHJACCARD, 16).
    WithElementBitWidth(64).
    WithRawData(true)

err = cli.CreateCollection(ctx, milvusclient.NewCreateCollectionOption("minhash_demo", schema).
    WithIndexOptions(milvusclient.NewCreateIndexOption("minhash_demo", "minhash_signature", idx)))
if err != nil {
    log.Fatal(err)
}
use milvus::v2::prelude::*;
use std::collections::HashMap;

let index_param = IndexParam::new()
    .field_name("minhash_signature")
    .index_type(IndexType::MinhashLsh)
    .metric_type(MetricType::MhJaccard)
    .extra_params(HashMap::from([
        ("mh_element_bit_width".into(), "64".into()),
        ("mh_lsh_band".into(), "16".into()),
        ("with_raw_data".into(), "true".into()),
    ]));

client
    .create_collection(
        CreateCollectionRequest::builder()
            .collection_name("minhash_demo")
            .schema(schema)
            .index_param(index_param)
            .build()?,
    )
    .await?;
milvus::IndexDesc index_vector("minhash_signature", "", milvus::IndexType::MINHASH_LSH, milvus::MetricType::MHJACCARD);
index_vector.AddExtraParam("mh_element_bit_width", "64");
index_vector.AddExtraParam("mh_lsh_band", "16");
index_vector.AddExtraParam("with_raw_data", "true");

auto status = client->CreateCollection(milvus::CreateCollectionRequest()
                                .WithCollectionName("minhash_demo")
                                .WithCollectionSchema(schema)
                                .AddIndex(std::move(index_vector)));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
await client.createCollection({
  collection_name: 'minhash_demo',
  fields: schema,
  index_params: [{
    field_name: 'minhash_signature',
    index_type: 'MINHASH_LSH',
    metric_type: 'MHJACCARD',
    params: { mh_element_bit_width: 64, mh_lsh_band: 16, with_raw_data: true },
  }],
});
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
--data "{
    \"collectionName\": \"minhash_demo\",
    \"schema\": ${SCHEMA},
    \"indexParams\": [
        {
            \"fieldName\": \"minhash_signature\",
            \"indexType\": \"MINHASH_LSH\",
            \"metricType\": \"MHJACCARD\",
            \"params\": {\"mh_element_bit_width\": \"64\", \"mh_lsh_band\": \"16\", \"with_raw_data\": \"true\"}
        }
    ]
}"
关于索引构建参数的更多信息,请参考索引构建参数。
写入数据
为每个文档准备:
-
一个二进制 MinHash 签名
-
一个序列化的 token 集合字符串
-
(可选)原始文本
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
documents = [
    "machine learning algorithms process data automatically",
    "deep learning uses neural networks to model patterns"
]

insert_data = []
for i, doc in enumerate(documents):
    sig = generate_minhash_signature(doc)
    token_str = extract_token_set(doc)
    insert_data.append({
        "doc_id": i,
        "minhash_signature": sig,
        "token_set": token_str,
        "document": doc
    })

client.insert("minhash_demo", insert_data)
client.flush("minhash_demo")
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;

import java.util.ArrayList;
import java.util.List;

// MinHash signatures (2048 bytes each) generated externally, e.g. via datasketch.
// `signatures[i]` corresponds to `documents[i]`.
String[] documents = {
    "machine learning algorithms process data automatically",
    "deep learning uses neural networks to model patterns"
};
String[] tokenSets = {
    "automatically learning data machine algorithms process",
    "learning uses deep neural networks to model patterns"
};
byte[][] signatures = { signature0, signature1 };

Gson gson = new Gson();
List<JsonObject> rows = new ArrayList<>();
for (int i = 0; i < documents.length; i++) {
    JsonObject row = new JsonObject();
    row.addProperty("doc_id", i);
    row.add("minhash_signature", gson.toJsonTree(signatures[i]));
    row.addProperty("token_set", tokenSets[i]);
    row.addProperty("document", documents[i]);
    rows.add(row);
}

client.insert(InsertReq.builder()
        .collectionName("minhash_demo")
        .data(rows)
        .build());
import (
    "github.com/milvus-io/milvus/client/v3/column"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

// MinHash signatures (2048 bytes each) generated externally, e.g. via datasketch.
// `signatures[i]` corresponds to `documents[i]`.
documents := []string{
    "machine learning algorithms process data automatically",
    "deep learning uses neural networks to model patterns",
}
tokenSets := []string{
    "automatically learning data machine algorithms process",
    "learning uses deep neural networks to model patterns",
}
signatures := [][]byte{signature0, signature1}

result, err := cli.Insert(ctx, milvusclient.NewColumnBasedInsertOption("minhash_demo").
    WithInt64Column("doc_id", []int64{0, 1}).
    WithColumns(
        column.NewColumnBinaryVector("minhash_signature", 16384, signatures),
        column.NewColumnVarChar("token_set", tokenSets),
        column.NewColumnVarChar("document", documents),
    ))
if err != nil {
    log.Fatal(err)
}
log.Println("insert count:", result.InsertCount)
use milvus::v2::prelude::*;
use serde_json::json;

// MinHash signatures (2048 bytes each) generated externally, e.g. via datasketch.
// `signatures[i]` corresponds to `documents[i]`.
let documents = [
    "machine learning algorithms process data automatically",
    "deep learning uses neural networks to model patterns",
];
let token_sets = [
    "automatically learning data machine algorithms process",
    "learning uses deep neural networks to model patterns",
];
let signatures: [Vec<u8>; 2] = [signature0, signature1];

for i in 0..documents.len() {
    client
        .insert(
            InsertRequest::builder()
                .collection_name("minhash_demo")
                .row(json!({
                    "doc_id": i,
                    "minhash_signature": signatures[i],
                    "token_set": token_sets[i],
                    "document": documents[i],
                }))
                .build()?,
        )
        .await?;
}
// MinHash signatures (2048 bytes each) generated externally, e.g. via datasketch.
// `signatures[i]` corresponds to `documents[i]`.
std::vector<std::vector<uint8_t>> signatures = {signature0, signature1};

milvus::EntityRows data = {
    {{"doc_id", 0}, {"minhash_signature", signatures[0]},
     {"token_set", "automatically learning data machine algorithms process"},
     {"document", "machine learning algorithms process data automatically"}},
    {{"doc_id", 1}, {"minhash_signature", signatures[1]},
     {"token_set", "learning uses deep neural networks to model patterns"},
     {"document", "deep learning uses neural networks to model patterns"}},
};

milvus::InsertResponse response;
auto status = client->Insert(milvus::InsertRequest()
                                .WithCollectionName("minhash_demo")
                                .WithRowsData(std::move(data)),
                             response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
// MinHash signatures (2048 bytes each) generated externally, e.g. via datasketch.
// `signatures[i]` corresponds to `documents[i]`.
const documents = [
  'machine learning algorithms process data automatically',
  'deep learning uses neural networks to model patterns',
];
const tokenSets = [
  'automatically learning data machine algorithms process',
  'learning uses deep neural networks to model patterns',
];
const signatures = [signature0, signature1]; // Buffer(2048) each

const rows = documents.map((doc, i) => ({
  doc_id: i,
  minhash_signature: signatures[i],
  token_set: tokenSets[i],
  document: doc,
}));

await client.insert({
  collection_name: 'minhash_demo',
  data: rows,
});
# MinHash signatures (2048 bytes each) generated externally, e.g. via datasketch,
# and base64-encoded for the REST insert.
SIGNATURE_0="<base64 of the 2048-byte MinHash signature>"
SIGNATURE_1="<base64 of the 2048-byte MinHash signature>"

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
--data "{
    \"collectionName\": \"minhash_demo\",
    \"data\": [
        {
            \"doc_id\": 0,
            \"minhash_signature\": \"${SIGNATURE_0}\",
            \"token_set\": \"automatically learning data machine algorithms process\",
            \"document\": \"machine learning algorithms process data automatically\"
        },
        {
            \"doc_id\": 1,
            \"minhash_signature\": \"${SIGNATURE_1}\",
            \"token_set\": \"learning uses deep neural networks to model patterns\",
            \"document\": \"deep learning uses neural networks to model patterns\"
        }
    ]
}"
执行相似度搜索
Zilliz Cloud 在 MinHash LSH 上支持两种相似度搜索模式:
-
近似搜索——仅使用 MinHash 签名和 LSH,速度快但结果为概率近似。
-
精排搜索——基于原始 token 集合重新计算 Jaccard 相似度,精度更高。
5.1 准备查询
要执行相似度搜索,先为查询文档生成 MinHash 签名。该签名的维度和编码格式必须与写入数据时一致。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
query_text = "deep learning uses neural networks to model patterns"
query_sig = generate_minhash_signature(query_text)
String queryText = "deep learning uses neural networks to model patterns";
// MinHash signature of the query text, generated externally (e.g., via datasketch).
byte[] querySignature = querySignatureBytes;
queryText := "deep learning uses neural networks to model patterns"
// MinHash signature of the query text, generated externally (e.g., via datasketch).
querySignature := querySignatureBytes
let query_text = "deep learning uses neural networks to model patterns";
// MinHash signature of the query text, generated externally (e.g., via datasketch).
let query_signature: Vec<u8> = query_signature_bytes;
std::string query_text = "deep learning uses neural networks to model patterns";
// MinHash signature of the query text, generated externally (e.g., via datasketch).
std::vector<uint8_t> query_signature = query_signature_bytes;
const queryText = 'deep learning uses neural networks to model patterns';
// MinHash signature of the query text, generated externally (e.g., via datasketch).
const querySignature = querySignatureBytes; // Buffer(2048)
# MinHash signature of the query text, generated externally (e.g., via datasketch),
# and base64-encoded for the REST search request.
QUERY_SIGNATURE="<base64 of the query MinHash signature>"

# Load the collection before searching (REST does not auto-load).
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/load" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--data '{"collectionName": "minhash_demo"}'
5.2 近似搜索(仅使用 LSH)
这种方式快速且可扩展,但可能漏掉某些近似匹配或产生误判:
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
search_params={
    "metric_type": "MHJACCARD",
    "params": {}
}

approx_results = client.search(
    collection_name="minhash_demo",
    data=[query_sig],
    anns_field="minhash_signature",
    search_params=search_params,
    limit=3,
    output_fields=["doc_id", "document"],
    consistency_level="Strong"
)

for i, hit in enumerate(approx_results[0]):
    sim = hit['distance']
    print(f"{i+1}. Similarity: {sim:.3f} | {hit['entity']['document']}")
import io.milvus.v2.common.IndexParam;
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.request.data.BinaryVec;
import io.milvus.v2.service.vector.response.SearchResp;

import java.util.Collections;

// Approximate search (LSH-only): uses only MinHash signatures and LSH.
SearchResp approxResp = client.search(SearchReq.builder()
        .collectionName("minhash_demo")
        .annsField("minhash_signature")
        .data(Collections.singletonList(new BinaryVec(querySignature)))
        .metricType(IndexParam.MetricType.MHJACCARD)
        .searchParams(Collections.emptyMap())
        .limit(3)
        .outputFields(Collections.singletonList("document"))
        .build());

for (SearchResp.SearchResult hit : approxResp.getSearchResults().get(0)) {
    double sim = hit.getScore();
    System.out.printf("Similarity: %.3f | %s%n", sim, hit.getEntity().get("document"));
}
import (
    "github.com/milvus-io/milvus/client/v3/entity"
    "github.com/milvus-io/milvus/client/v3/index"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

// Approximate search (LSH-only): uses only MinHash signatures and LSH.
resultSets, err := cli.Search(ctx, milvusclient.NewSearchOption("minhash_demo", 3, []entity.Vector{entity.BinaryVector(querySignature)}).
    WithANNSField("minhash_signature").
    WithAnnParam(index.NewMinHashLSHAnnParam()).
    WithOutputFields("doc_id", "document"))
if err != nil {
    log.Fatal(err)
}
for _, resultSet := range resultSets {
    docCol := resultSet.GetColumn("document")
    for i := 0; i < resultSet.ResultCount; i++ {
        doc, _ := docCol.GetAsString(i)
        log.Printf("Similarity: %.3f | %s", resultSet.Scores[i], doc)
    }
}
// Approximate search (LSH-only): uses only MinHash signatures and LSH.
let response = client
    .search(
        SearchRequest::builder()
            .collection_name("minhash_demo")
            .vector_field("minhash_signature")
            .vectors(SearchVectors::Binary(vec![query_signature]))
            .metric_type(MetricType::MhJaccard)
            .limit(3)
            .output_fields(["doc_id", "document"])
            .build()?,
    )
    .await?;

for result in response.results() {
    for row in result.rows()? {
        let entity = row.to_entity_row()?;
        let sim = entity.get("distance").unwrap_or_default();
        println!("{:?}", entity);
    }
}
// Approximate search (LSH-only): uses only MinHash signatures and LSH.
auto request = milvus::SearchRequest()
                    .WithCollectionName("minhash_demo")
                    .WithAnnsField("minhash_signature")
                    .WithMetricType(milvus::MetricType::MHJACCARD)
                    .WithLimit(3)
                    .AddOutputField("doc_id")
                    .AddOutputField("document")
                    .AddBinaryVector(query_signature);

milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

auto search_results = response.Results();
for (auto& result : search_results.Results()) {
    milvus::EntityRows rows;
    status = result.OutputRows(rows);
    for (const auto& row : rows) {
        std::cout << row << std::endl;
    }
}
// Approximate search (LSH-only): uses only MinHash signatures and LSH.
const approx_results = await client.search({
  collection_name: 'minhash_demo',
  data: [querySignature],
  anns_field: 'minhash_signature',
  metric_type: 'MHJACCARD',
  params: {},
  limit: 3,
  output_fields: ['doc_id', 'document'],
  consistency_level: 'Strong',
});
for (const hit of approx_results.results) {
  const sim = hit.score;
  console.log(`Similarity: ${sim.toFixed(3)} | ${hit.document}`);
}
# Approximate search (LSH-only): uses only MinHash signatures and LSH.
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
--data "{
    \"collectionName\": \"minhash_demo\",
    \"data\": [\"${QUERY_SIGNATURE}\"],
    \"annsField\": \"minhash_signature\",
    \"metricType\": \"MHJACCARD\",
    \"limit\": 3,
    \"outputFields\": [\"doc_id\", \"document\"]
}"
5.3 精排搜索(推荐用于追求精度的场景)
这种方式基于存储在 Zilliz Cloud 中的原始 token 集合进行精确的 Jaccard 比较。速度略慢,但适用于对结果质量要求较高的任务:
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
search_params = {
    "metric_type": "MHJACCARD",
    "params": {
        "mh_search_with_jaccard": True,  # Enable real Jaccard computation
        "refine_k": 5                    # Refine top 5 candidates
    }
}

refined_results = client.search(
    collection_name="minhash_demo",
    data=[query_sig],
    anns_field="minhash_signature",
    search_params=search_params,
    limit=3,
    output_fields=["doc_id", "document"],
    consistency_level="Strong"
)

for i, hit in enumerate(refined_results[0]):
    sim = hit['distance']
    print(f"{i+1}. Similarity: {sim:.3f} | {hit['entity']['document']}")
import io.milvus.v2.common.IndexParam;
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.request.data.BinaryVec;
import io.milvus.v2.service.vector.response.SearchResp;

import java.util.Collections;

// Refined search: re-computes the exact Jaccard similarity on the candidates.
SearchResp refinedResp = client.search(SearchReq.builder()
        .collectionName("minhash_demo")
        .annsField("minhash_signature")
        .data(Collections.singletonList(new BinaryVec(querySignature)))
        .metricType(IndexParam.MetricType.MHJACCARD)
        .searchParams(new java.util.HashMap<String, Object>() {{
            put("mh_search_with_jaccard", true);
            put("refine_k", 5);
        }})
        .limit(3)
        .outputFields(Collections.singletonList("document"))
        .build());

for (SearchResp.SearchResult hit : refinedResp.getSearchResults().get(0)) {
    double sim = hit.getScore();
    System.out.printf("Similarity: %.3f | %s%n", sim, hit.getEntity().get("document"));
}
import (
    "github.com/milvus-io/milvus/client/v3/entity"
    "github.com/milvus-io/milvus/client/v3/index"
    "github.com/milvus-io/milvus/client/v3/milvusclient"
)

// Refined search: re-computes the exact Jaccard similarity on the candidates.
resultSets, err := cli.Search(ctx, milvusclient.NewSearchOption("minhash_demo", 3, []entity.Vector{entity.BinaryVector(querySignature)}).
    WithANNSField("minhash_signature").
    WithSearchParam("params", `{"mh_search_with_jaccard":true,"refine_k":5}`).
    WithOutputFields("doc_id", "document"))
if err != nil {
    log.Fatal(err)
}
for _, resultSet := range resultSets {
    docCol := resultSet.GetColumn("document")
    for i := 0; i < resultSet.ResultCount; i++ {
        doc, _ := docCol.GetAsString(i)
        log.Printf("Similarity: %.3f | %s", resultSet.Scores[i], doc)
    }
}
// Note: Refined search (`mh_search_with_jaccard` / `refine_k`) is not supported
// in milvus-sdk-rust as of v3.0.2 — search params are string-typed, and the
// server rejects the string form for MINHASH refinement. Use the approximate
// LSH search above instead; refined Jaccard search is available in the
// Python, Java, Go, and Node.js SDKs.
// Refined search: re-computes the exact Jaccard similarity on the candidates.
auto request = milvus::SearchRequest()
                    .WithCollectionName("minhash_demo")
                    .WithAnnsField("minhash_signature")
                    .WithMetricType(milvus::MetricType::MHJACCARD)
                    .WithExtraParams({{"mh_search_with_jaccard", "true"}, {"refine_k", "5"}})
                    .WithLimit(3)
                    .AddOutputField("doc_id")
                    .AddOutputField("document")
                    .AddBinaryVector(query_signature);

milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

auto search_results = response.Results();
for (auto& result : search_results.Results()) {
    milvus::EntityRows rows;
    status = result.OutputRows(rows);
    for (const auto& row : rows) {
        std::cout << row << std::endl;
    }
}
// Refined search: re-computes the exact Jaccard similarity on the candidates.
const refined_results = await client.search({
  collection_name: 'minhash_demo',
  data: [querySignature],
  anns_field: 'minhash_signature',
  metric_type: 'MHJACCARD',
  params: {
    mh_search_with_jaccard: true,
    refine_k: 5,
  },
  limit: 3,
  output_fields: ['doc_id', 'document'],
  consistency_level: 'Strong',
});
for (const hit of refined_results.results) {
  const sim = hit.score;
  console.log(`Similarity: ${sim.toFixed(3)} | ${hit.document}`);
}
# The REST API accepts only numeric values in search `params`, so the boolean
# `mh_search_with_jaccard` cannot be expressed. Use the approximate LSH search
# (refined Jaccard search is available via the SDKs).
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
--data "{
    \"collectionName\": \"minhash_demo\",
    \"data\": [\"${QUERY_SIGNATURE}\"],
    \"annsField\": \"minhash_signature\",
    \"metricType\": \"MHJACCARD\",
    \"limit\": 3,
    \"outputFields\": [\"doc_id\", \"document\"]
}"
索引参数
本节介绍构建索引以及在该索引上执行搜索时所使用的参数。
索引构建参数
下表列出了在构建索引时可以在 params 中配置的参数。
| 参数 | 说明 | 取值范围 | 调优建议 |
|---|---|---|---|
mh_element_bit_width | MinHash 签名中每个哈希值的位宽。必须是 8 的倍数。 | 8、16、32、64 | 使用 32 在性能和精度之间取得平衡。对于大规模数据集,使用 64 可获得更高的精度。如需节省内存且可接受一定精度损失,可使用 16。 |
mh_lsh_band | LSH 中划分 MinHash 签名所使用的 band 数量。用于控制召回率与性能之间的权衡。 | [1, signature_length] | 对于 128 维签名:建议从 32 个 band(每个 band 4 个值)开始;增加到 64 可提高召回率,减少到 16 可获得更好的性能。该值必须能整除签名长度。 |
mh_lsh_code_in_mem | 是否将 LSH 哈希码存储于匿名内存中(true),或使用内存映射(false)。 | true、false | 对于大规模数据集(>1M 集合),使用 false 以降低内存占用。对于需要极致搜索速度的小规模数据集,使用 true。 |
with_raw_data | 是否将原始 MinHash 签名与 LSH 哈希码一同存储以支持精排。 | true、false | 当对精度要求较高且能接受额外存储开销时,使用 true。当希望以轻微精度损失换取更低存储开销时,使用 false。 |
mh_lsh_bloom_false_positive_prob | 用于 LSH 桶优化的布隆过滤器的误判率。 | [0.001, 0.1] | 使用 0.01 在内存占用与精度之间取得平衡。较低的值(0.001)可减少误判,但会增加内存开销;较高的值(0.05)可节省内存,但可能降低精度。 |
索引相关搜索参数
下表列出了在基于该索引执行搜索时可在 search_params.params 中配置的参数。
| 参数 | 说明 | 取值范围 | 调优建议 |
|---|---|---|---|
mh_search_with_jaccard | 是否对候选结果执行精确的 Jaccard 相似度计算以进行精排。 | true、false | 对于精度要求高的应用(如去重),使用 true。当可以接受一定精度损失以换取更快的近似搜索时,使用 false。 |
refine_k | 在执行 Jaccard 精排前要检索的候选数量。仅在 mh_search_with_jaccard 为 true 时生效。 | [top_k, top_k * 10] | 建议设为目标 top_k 的 2-5 倍,以兼顾召回率和性能。该值越大召回越好,但计算成本也越高。 |
mh_lsh_batch_search | 是否在多个查询并发执行时启用批量优化。 | true、false | 同时执行多个查询时使用 true 以获得更高的吞吐。单查询场景下使用 false 以降低内存开销。 |