Binary 向量
Binary 向量是一种特殊的数据表示形式,通过将传统的高维浮点向量转换为仅包含 0 和 1 的二进制向量。这种转换不仅压缩了向量的大小,还能够在保留语义信息的同时,减少存储和计算成本。在非关键特征的精度要求较低的情况下,Binary 向量能够有效保留大部分原始浮点向量的完整性和实用性。
Binary 向量的应用场景非常广泛,尤其是在计算效率和存储优化至关重要的情况下。在大型 AI 系统中(如搜索引擎或推荐系统),实时处理海量数据是关键。通过减少向量的大小,Binary 向量能够在不显著牺牲准确性的情况下,帮助减少延迟和计算成本。此外,Binary 向量在资源受限的环境中也很有用,例如移动设备和嵌入式系统,这些场景中内存和处理能力有限。通过使用 Binary 向量,复杂的 AI 功能得以在这些限制条件下实现,同时保持较高的运行效率。
概述
Binary 向量是一种将复杂对象(如图像、文本或音频)编码为固定长度二进制串的向量表示方法。在 Zilliz Cloud 中,Binary 向量通常表示为位数组或字节数组。例如,一个 8 维的 Binary 向量可以表示为 [1, 0, 1, 1, 0, 0, 1, 0]。
下图展示了 Binary 向量如何表示文本内容中关键词的出现情况。本例中,我们使用一个 10 维的 Binary 向量来表示两个不同的文本(文本 1 和文本 2),其中每个维度对应词汇表中的一个词, 1 表示该词在文本中出现,0 表示未出现。
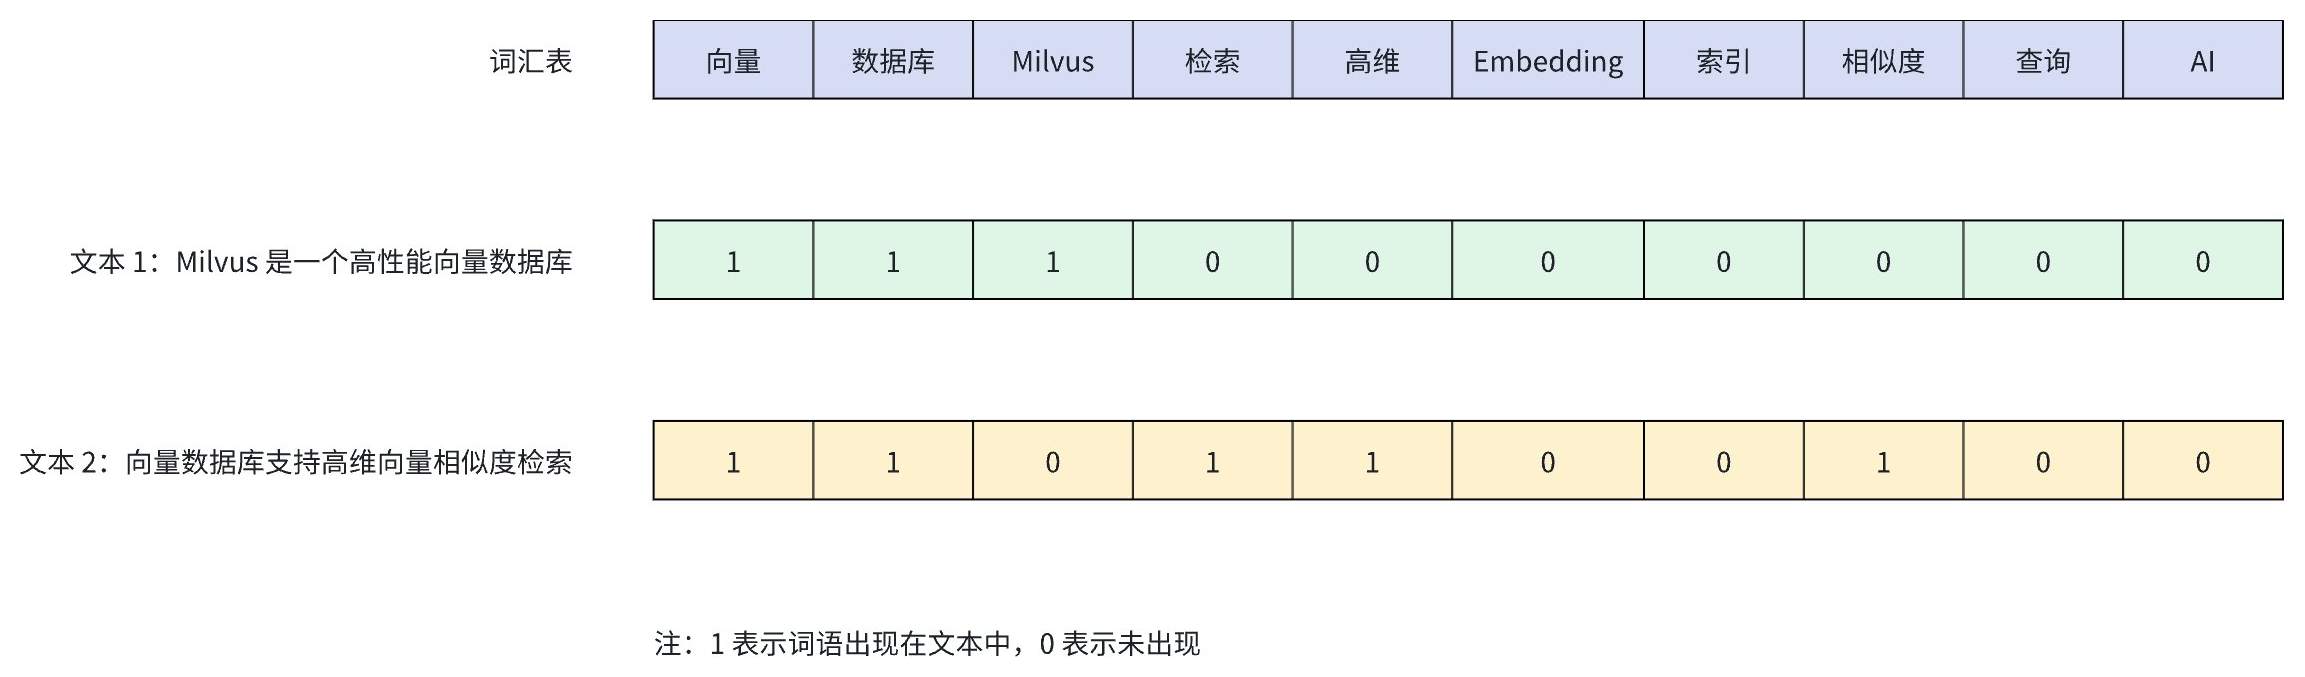
Binary 向量表示法具有以下特点:
-
高效存储:每个维度只需 1 bit 存储,大大节省了存储空间。
-
快速计算:使用位运算(如 XOR)可以快速计算向量间的相似度。
-
固定长度:无论原始文本长度如何,向量长度保持不变,便于索引和检索。
-
简单直观:直接反映了关键词的出现情况,适合某些特定的检索任务。
Binary 向量可以通过多种方法生成。在文本处理中,可以使用预定义的词汇表,根据词语出现与否设置相应位。图像处理中,可以使用感知哈希算法(如 pHash)生成图像的 Binary 特征。在机器学习应用中,可以将模型输出二值化,得到 Binary 向量表示。
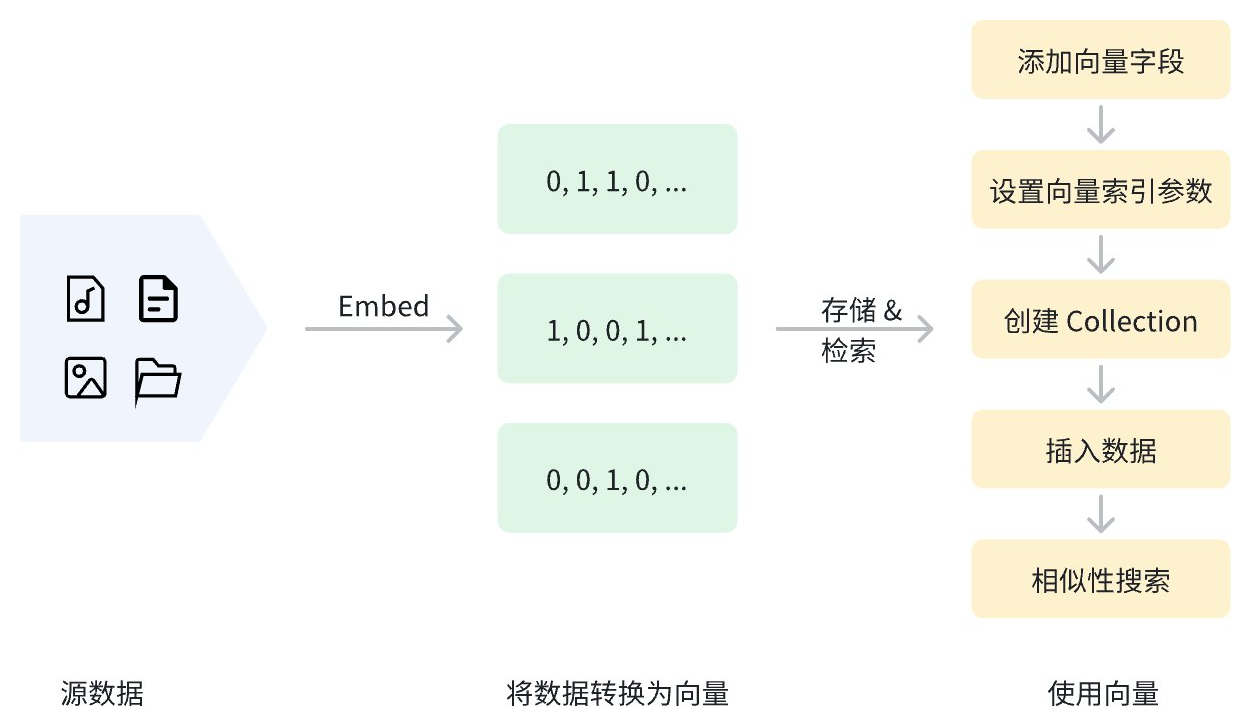
数据在向量化后,可以存储在 Zilliz Cloud 中进行管理和向量检索。下图展示了基本流程。
使用 Binary 向量
添加 Binary 向量字段
要在 Zilliz Cloud 中使用 Binary 向量,首先需要在创建 Collection 时定义用于存储 Binary 向量的向量字段。这个过程包括:
-
设置
datatype为支持的 Binary 向量数据类型,即BINARY_VECTOR。 -
使用
dim参数指定向量的维度。注意,dim必须是 8 的倍数,因为 Binary 向量在插入时需要转换为 byte 数组。每 8 个布尔值(0 或 1)将被打包为 1 个 byte。例如,如果dim=128,则插入时需要提供 16 个 byte 的数组。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
from pymilvus import MilvusClient, DataType

client = MilvusClient(uri="YOUR_CLUSTER_ENDPOINT")

schema = client.create_schema(
    auto_id=True,
    enable_dynamic_fields=True,
)

schema.add_field(field_name="pk", datatype=DataType.VARCHAR, is_primary=True, max_length=100)
schema.add_field(field_name="binary_vector", datatype=DataType.BINARY_VECTOR, dim=128)
import io.milvus.v2.client.ConnectConfig;
import io.milvus.v2.client.MilvusClientV2;
import io.milvus.v2.common.DataType;
import io.milvus.v2.service.collection.request.AddFieldReq;
import io.milvus.v2.service.collection.request.CreateCollectionReq;

MilvusClientV2 client = new MilvusClientV2(ConnectConfig.builder()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN")
        .build());

CreateCollectionReq.CollectionSchema schema = MilvusClientV2.CreateSchema();
schema.setEnableDynamicField(true);
schema.addField(AddFieldReq.builder()
        .fieldName("pk")
        .dataType(DataType.VarChar)
        .isPrimaryKey(true)
        .autoID(true)
        .maxLength(100)
        .build());

schema.addField(AddFieldReq.builder()
        .fieldName("binary_vector")
        .dataType(DataType.BinaryVector)
        .dimension(128)
        .build());
import (
    "context"
    "fmt"

    "github.com/milvus-io/milvus/client/v3/entity"
    milvusclient "github.com/milvus-io/milvus/client/v3/milvusclient"
)

ctx, cancel := context.WithCancel(context.Background())
defer cancel()

client, err := milvusclient.New(ctx, &milvusclient.ClientConfig{
    Address: "YOUR_CLUSTER_ENDPOINT",
    APIKey:  "YOUR_CLUSTER_TOKEN",
})
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
defer client.Close(ctx)

schema := entity.NewSchema().WithEnableDynamicField(true).
    WithField(entity.NewField().
        WithName("pk").
        WithDataType(entity.FieldTypeVarChar).
        WithIsAutoID(true).
        WithIsPrimaryKey(true).
        WithMaxLength(100),
    ).WithField(entity.NewField().
        WithName("binary_vector").
        WithDataType(entity.FieldTypeBinaryVector).
        WithDim(128),
    )
use milvus::v2::prelude::*;

let client = ClientV2::new(
    &ConnectConfig::new()
        .uri("YOUR_CLUSTER_ENDPOINT")
        .token("YOUR_CLUSTER_TOKEN"),
)
.await?;

let mut schema = CollectionSchema::new().enable_dynamic_field(true);
schema = schema
    .add_field(
        FieldSchema::new()
            .name("pk")
            .data_type(DataType::VarChar)
            .primary_key(true)
            .auto_id(true)
            .max_length(100),
    )
    .add_field(
        FieldSchema::new()
            .name("binary_vector")
            .data_type(DataType::BinaryVector)
            .dimension(128),
    );
#include "milvus/MilvusClientV2.h"

auto client = milvus::MilvusClientV2::Create();

milvus::ConnectParam connect_param{"YOUR_CLUSTER_ENDPOINT", "YOUR_CLUSTER_TOKEN"};
auto status = client->Connect(connect_param);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}

milvus::CollectionSchemaPtr schema = std::make_shared<milvus::CollectionSchema>();
schema->SetEnableDynamicField(true);
schema->AddField(milvus::FieldSchema("pk", milvus::DataType::VARCHAR, "", true, true).WithMaxLength(100));
schema->AddField(milvus::FieldSchema("binary_vector", milvus::DataType::BINARY_VECTOR).WithDimension(128));
import { DataType } from "@zilliz/milvus2-sdk-node";

schema.push({
  name: "binary_vector",
  data_type: DataType.BinaryVector,
  dim: 128,
});
export primaryField='{
    "fieldName": "pk",
    "dataType": "VarChar",
    "isPrimary": true,
    "elementTypeParams": {
        "max_length": 100
    }
}'

export vectorField='{
    "fieldName": "binary_vector",
    "dataType": "BinaryVector",
    "elementTypeParams": {
        "dim": 128
    }
}'

export schema="{
    \"autoID\": true,
    \"fields\": [
        $primaryField,
        $vectorField
    ],
    \"enableDynamicField\": true
}"
以上示例中,我们添加了一个名为 binary_vector 的向量字段,用于存储 Binary 向量。该字段的数据类型为 BINARY_VECTOR,向量维度为 128。
为 Binary 向量创建索引
为了加速搜索,我们需要为 Binary 向量字段创建索引。索引可以显著提高大规模向量数据的检索效率。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
index_params = client.prepare_index_params()

index_params.add_index(
    field_name="binary_vector",
    index_name="binary_vector_index",
    index_type="AUTOINDEX",
    metric_type="HAMMING"
)
import io.milvus.v2.common.IndexParam;
import java.util.*;

List<IndexParam> indexParams = new ArrayList<>();

indexParams.add(IndexParam.builder()
        .fieldName("binary_vector")
        .indexName("binary_vector_index")
        .indexType(IndexParam.IndexType.AUTOINDEX)
        .metricType(IndexParam.MetricType.HAMMING)
        .build());
idx := index.NewAutoIndex(entity.HAMMING)
indexOption := milvusclient.NewCreateIndexOption("my_collection", "binary_vector", idx)
let index_params = vec![IndexParam::new()
    .field_name("binary_vector")
    .index_name("binary_vector_index")
    .index_type(IndexType::AutoIndex)
    .metric_type(MetricType::Hamming)];
std::vector<milvus::IndexDesc> indexes = {
    milvus::IndexDesc("binary_vector", "binary_vector_index", milvus::IndexType::AUTOINDEX, milvus::MetricType::HAMMING)
};
import { MetricType, IndexType } from "@zilliz/milvus2-sdk-node";

const indexParams = {
  indexName: "binary_vector_index",
  field_name: "binary_vector",
  metric_type: MetricType.HAMMING,
  index_type: IndexType.AUTOINDEX
};
export indexParams='[
        {
            "fieldName": "binary_vector",
            "metricType": "HAMMING",
            "indexName": "binary_vector_index",
            "indexType": "AUTOINDEX"
        }
    ]'
以上示例中,我们为 binary_vector 字段创建了一个名为 binary_vector_index 的索引,索引类型为 AUTOINDEX。 metric_type 设置为 HAMMING,表示使用汉明(Hamming)距离作为相似性度量。
除了 HAMMING 相似度类型,Zilliz Cloud 还支持为 Binary 向量指定其他度量类型。具体请参考相似度类型。
创建 Collection
Binary 向量和索引定义完成后,我们便可以创建包含 Binary 向量的 Collection。以下示例通过 create_collection 方法创建了一个名为 my_binary_collection 的 Collection。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
client.create_collection(
    collection_name="my_collection",
    schema=schema,
    index_params=index_params
)
import io.milvus.v2.service.collection.request.CreateCollectionReq;

CreateCollectionReq requestCreate = CreateCollectionReq.builder()
        .collectionName("my_collection")
        .collectionSchema(schema)
        .indexParams(indexParams)
        .build();
client.createCollection(requestCreate);
err = client.CreateCollection(ctx,
    milvusclient.NewCreateCollectionOption("my_collection", schema).
        WithIndexOptions(indexOption))
if err != nil {
    fmt.Println(err.Error())
    // handle error
}
client
    .create_collection(
        CreateCollectionRequest::builder()
            .collection_name("my_collection")
            .schema(schema)
            .index_params(index_params)
            .build()?,
    )
    .await?;
auto status = client->CreateCollection(milvus::CreateCollectionRequest()
                                        .WithCollectionName("my_collection")
                                        .WithIndexes(std::move(indexes))
                                        .WithCollectionSchema(schema));
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
import { MilvusClient } from "@zilliz/milvus2-sdk-node";

await client.createCollection({
    collection_name: 'my_collection',
    schema: schema,
    index_params: indexParams
});
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/collections/create" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"schema\": $schema,
    \"indexParams\": $indexParams
}"
插入 Binary 向量
创建 Collection 后,我们可以通过 insert 方法插入包含 Binary 向量的数据。注意,Binary 向量应当以 byte 数组形式提供,其中每个 byte 代表 8 个布尔值。
例如,对于 128 维的 Binary 向量,需要提供 16 个 byte 的数组(因为 128 位 ÷ 8 位/byte = 16 byte)。以下是插入数据的代码示例:
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
def convert_bool_list_to_bytes(bool_list):
    if len(bool_list) % 8 != 0:
        raise ValueError("The length of a boolean list must be a multiple of 8")

    byte_array = bytearray(len(bool_list) // 8)
    for i, bit in enumerate(bool_list):
        if bit == 1:
            index = i // 8
            shift = i % 8
            byte_array[index] |= (1 << shift)
    return bytes(byte_array)

bool_vectors = [
    [1, 0, 0, 1, 1, 0, 1, 1, 0, 1, 0, 1, 0, 1, 0, 0] + [0] * 112,
    [0, 1, 0, 1, 0, 1, 0, 0, 1, 1, 0, 0, 1, 1, 0, 1] + [0] * 112,
]

data = [{"binary_vector": convert_bool_list_to_bytes(bool_vector)} for bool_vector in bool_vectors]

client.insert(
    collection_name="my_collection",
    data=data
)
import com.google.gson.Gson;
import com.google.gson.JsonObject;
import io.milvus.v2.service.vector.request.InsertReq;
import io.milvus.v2.service.vector.response.InsertResp;
import java.nio.ByteBuffer;

// Binary vectors (128 bits = 16 bytes)
// vector1: [1,0,0,1,1,0,1,1, 0,1,0,1,0,1,0,0] + [0]*112
byte[] vector1 = new byte[16];
vector1[0] = (byte) 0xD9;
vector1[1] = 0x2A;

// vector2: [0,1,0,1,0,1,0,0, 1,1,0,0,1,1,0,1] + [0]*112
byte[] vector2 = new byte[16];
vector2[0] = 0x2A;
vector2[1] = (byte) 0xB3;

List<JsonObject> rows = new ArrayList<>();
Gson gson = new Gson();

JsonObject row1 = new JsonObject();
row1.add("binary_vector", gson.toJsonTree(vector1));
rows.add(row1);

JsonObject row2 = new JsonObject();
row2.add("binary_vector", gson.toJsonTree(vector2));
rows.add(row2);

InsertResp insertR = client.insert(InsertReq.builder()
        .collectionName("my_collection")
        .data(rows)
        .build());
_, err = client.Insert(ctx, milvusclient.NewColumnBasedInsertOption("my_collection").
    WithBinaryVectorColumn("binary_vector", 128, [][]byte{
        {0b11011001, 0b00101010, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0},
        {0b00101010, 0b10110011, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0},
    }))
if err != nil {
    fmt.Println(err.Error())
    // handle err
}
// Binary vectors (128 bits = 16 bytes)
let binary_vectors: Vec<Vec<u8>> = vec![
    vec![0xD9, 0x2A, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
    vec![0x2A, 0xB3, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0],
];

client
    .insert(
        InsertRequest::builder()
            .collection_name("my_collection")
            .columns(vec![FieldData::binary_vector(
                "binary_vector",
                binary_vectors,
            )])
            .build()?,
    )
    .await?;
// Binary vectors (128 bits = 16 bytes)
std::vector<uint8_t> vector1 = {0xD9, 0x2A, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0};
std::vector<uint8_t> vector2 = {0x2A, 0xB3, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0};

milvus::EntityRows data = {
    {{"binary_vector", vector1}},
    {{"binary_vector", vector2}}
};

milvus::InsertResponse response;
auto status = client->Insert(milvus::InsertRequest()
                                .WithCollectionName("my_collection")
                                .WithRowsData(std::move(data)),
                             response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
const data = [
  { binary_vector: [1,0,0,1,1,0,1,1,0,1,0,1,0,1,0,0] },
  { binary_vector: [0,1,0,1,0,1,0,0,1,1,0,0,1,1,0,1] },
];

await client.insert({
  collection_name: "my_collection",
  data: data,
});
curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/insert" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"data\": $data,
    \"collectionName\": \"my_collection\"
}"
基于 Binary 向量执行相似性搜索
相似性搜索是 Zilliz Cloud 的核心功能之一,可以根据向量之间的距离快速找到与查询向量最相似的数据。要基于 Binary 向量进行相似性搜索,您需要准备查询向量和搜索参数,然后执行 search 方法。
在搜索时,Binary 向量同样需要以 byte 数组的形式提供。确保查询向量的维度与定义 dim 时一致,并按照 8 个布尔值转换为 1 个 byte。
- Python
- Java
- Go
- Rust
- C++
- NodeJS
- cURL
search_params = {
    "params": {"nprobe": 10}
}

query_bool_list = [1, 0, 0, 1, 1, 0, 1, 1, 0, 1, 0, 1, 0, 1, 0, 0] + [0] * 112
query_vector = convert_bool_list_to_bytes(query_bool_list)

res = client.search(
    collection_name="my_collection",
    data=[query_vector],
    anns_field="binary_vector",
    search_params=search_params,
    limit=5,
    output_fields=["pk"]
)

print(res)

# Output
# data: ["[{'id': '453718927992172268', 'distance': 10.0, 'entity': {'pk': '453718927992172268'}}]"]
import io.milvus.v2.service.vector.request.SearchReq;
import io.milvus.v2.service.vector.request.data.BinaryVec;
import io.milvus.v2.service.vector.response.SearchResp;
import java.nio.ByteBuffer;

// query vector = vector1
byte[] queryBytes = new byte[16];
queryBytes[0] = (byte) 0xD9;
queryBytes[1] = 0x2A;
ByteBuffer queryVector = ByteBuffer.wrap(queryBytes);

Map<String,Object> searchParams = new HashMap<>();
searchParams.put("nprobe", 10);

SearchResp searchR = client.search(SearchReq.builder()
        .collectionName("my_collection")
        .data(Collections.singletonList(new BinaryVec(queryVector)))
        .annsField("binary_vector")
        .searchParams(searchParams)
        .topK(5)
        .outputFields(Collections.singletonList("pk"))
        .build());

System.out.println(searchR.getSearchResults());
queryVector := []byte{0b11011001, 0b00101010, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0}

annSearchParams := index.NewCustomAnnParam()
annSearchParams.WithExtraParam("nprobe", 10)
resultSets, err := client.Search(ctx, milvusclient.NewSearchOption(
    "my_collection", // collectionName
    5,               // limit
    []entity.Vector{entity.BinaryVector(queryVector)},
).WithANNSField("binary_vector").
    WithOutputFields("pk").
    WithAnnParam(annSearchParams))
if err != nil {
    fmt.Println(err.Error())
    // handle err
}

for _, resultSet := range resultSets {
    fmt.Println("IDs: ", resultSet.IDs.FieldData().GetScalars())
    fmt.Println("Scores: ", resultSet.Scores)
    fmt.Println("Pks: ", resultSet.GetColumn("pk").FieldData().GetScalars())
}
// query vector = vector1
let query_vector: Vec<u8> = vec![0xD9, 0x2A, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0];

let results = client
    .search(
        SearchRequest::builder()
            .collection_name("my_collection")
            .vector_field("binary_vector")
            .vectors(SearchVectors::Binary(vec![query_vector]))
            .limit(5)
            .output_fields(vec!["pk"])
            .metric_type(MetricType::Hamming)
            .build()?,
    )
    .await?;
println!("{:?}", results.results());
// query vector = vector1
std::vector<uint8_t> query_vector = {0xD9, 0x2A, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0, 0};

auto request = milvus::SearchRequest()
                   .WithCollectionName("my_collection")
                   .WithAnnsField("binary_vector")
                   .WithLimit(5)
                   .AddOutputField("pk")
                   .AddBinaryVector(query_vector);

milvus::SearchResponse response;
auto status = client->Search(request, response);
if (!status.IsOk()) {
    std::cout << status.Message() << std::endl;
}
auto search_results = response.Results();
for (auto& result : search_results.Results()) {
    milvus::EntityRows output_rows;
    status = result.OutputRows(output_rows);
    for (const auto& row : output_rows) {
        std::cout << "\t" << row << std::endl;
    }
}
const query_vector = [1,0,0,1,1,0,1,1,0,1,0,1,0,1,0,0];

await client.search({
    collection_name: 'my_collection',
    data: query_vector,
    anns_field: 'binary_vector',
    limit: 5,
    output_fields: ['pk'],
    params: { nprobe: 10 }
});
export searchParams='{
        "params":{"nprobe":10}
    }'

curl --request POST \
--url "${CLUSTER_ENDPOINT}/v2/vectordb/entities/search" \
--header "Authorization: Bearer ${TOKEN}" \
--header "Content-Type: application/json" \
--header "Request-Timeout: 10" \
-d "{
    \"collectionName\": \"my_collection\",
    \"data\": $data,
    \"annsField\": \"binary_vector\",
    \"limit\": 5,
    \"searchParams\":$searchParams,
    \"outputFields\": [\"pk\"]
}"
有关更多搜索相关信息,请参考基本 ANN Search。